AI エンジニアリング手法
まえがき
前回は、生成 AI の中心にある LLM そのものの仕組み(トークナイズ、Transformer、学習、Reasoning、コンテキストウィンドウ)を解説しました。
今回はその続きとして、「LLM をどう使いこなすか」という “活用側” の手法を取り上げます。
LLM は賢くなりましたが、ただ質問を投げるだけでは、その力を十分に引き出せないことも多々あります。そこで生まれてきたのが、AI エンジニアリングと呼ばれる一連の設計手法です。これは大きく次の 4 つに整理できます。
- プロンプトエンジニアリング
- コンテキストエンジニアリング
- ハーネスエンジニアリング
- ループエンジニアリング
この記事では、まず 4 つの全体像(変遷)をつかんだうえで、それぞれを順に解説し、最後に コーディングエージェントを例に「4 手法がどう組み合わさるか」を見ていきます。
なお、前回同様、本記事は厳密さよりも全体像をイメージとしてつかむことを優先しています。
0. AI エンジニアリング手法の変遷(全体像)
まず、4 つの手法の関係を俯瞰しておきます。
ざっくり言うと、LLM の活用は 「質問の工夫」から「システム設計」へと、設計の焦点がだんだん広がってきました。その流れが、プロンプト → コンテキスト → ハーネス → ループ という 4 段階です。
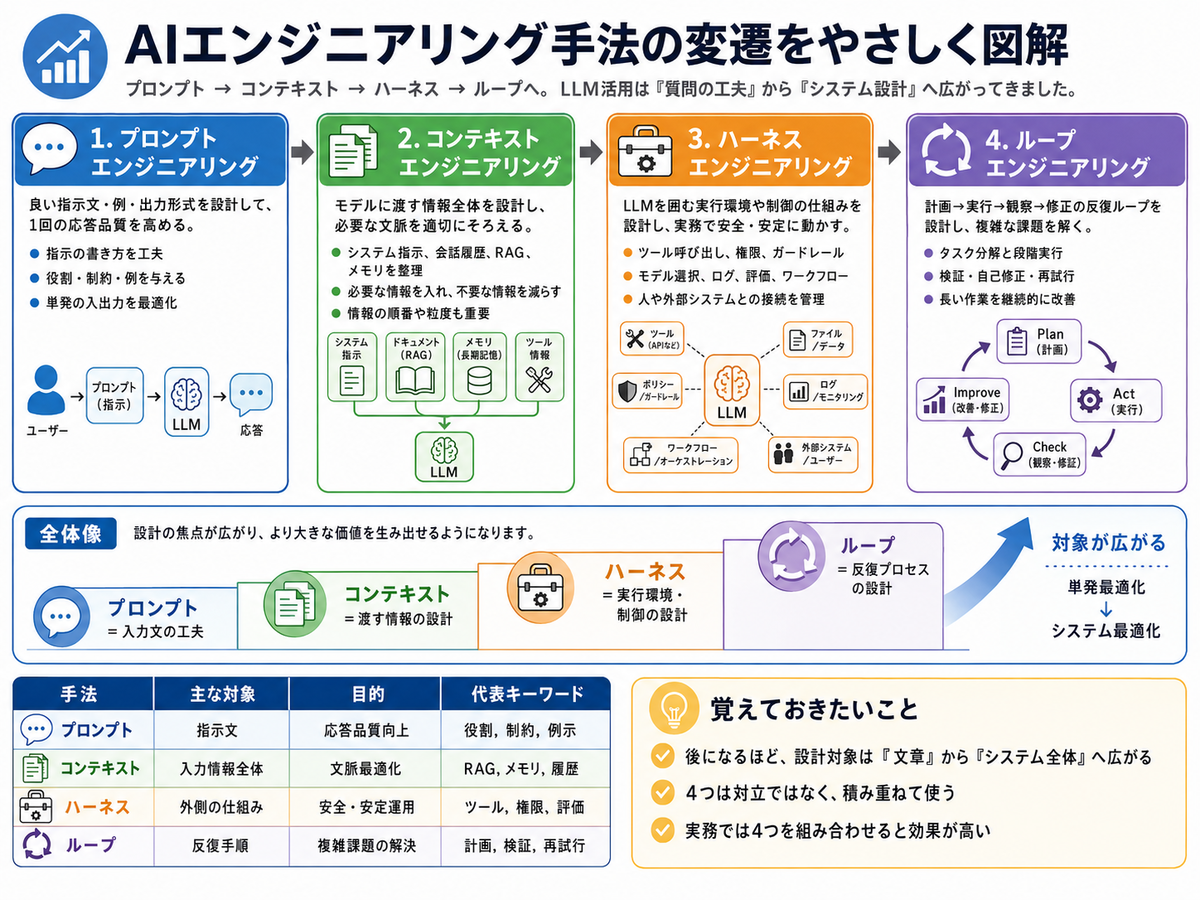
各手法の位置づけを一覧にすると、次のようになります。
| 手法 | 主な対象 | 目的 | 代表キーワード |
|---|---|---|---|
| プロンプト | 指示文 | 応答品質の向上 | 役割・制約・例示 |
| コンテキスト | 入力情報全体 | 文脈の最適化 | RAG・メモリ・履歴 |
| ハーネス | 外側の仕組み | 安全・安定運用 | ツール・権限・評価 |
| ループ | 反復手順 | 複雑な課題の解決 | 計画・検証・再試行 |
ここで押さえておきたいポイントは 3 つです。
- 後になるほど、設計の対象が 「文章」から「システム全体」へ広がる
- 4 つは対立する選択肢ではなく、積み重ねて使うもの
- 実務では、4 つを組み合わせるほど効果が高い
それでは、1 つずつ見ていきます。
1. プロンプトエンジニアリング
最初の段階は プロンプトエンジニアリングです。
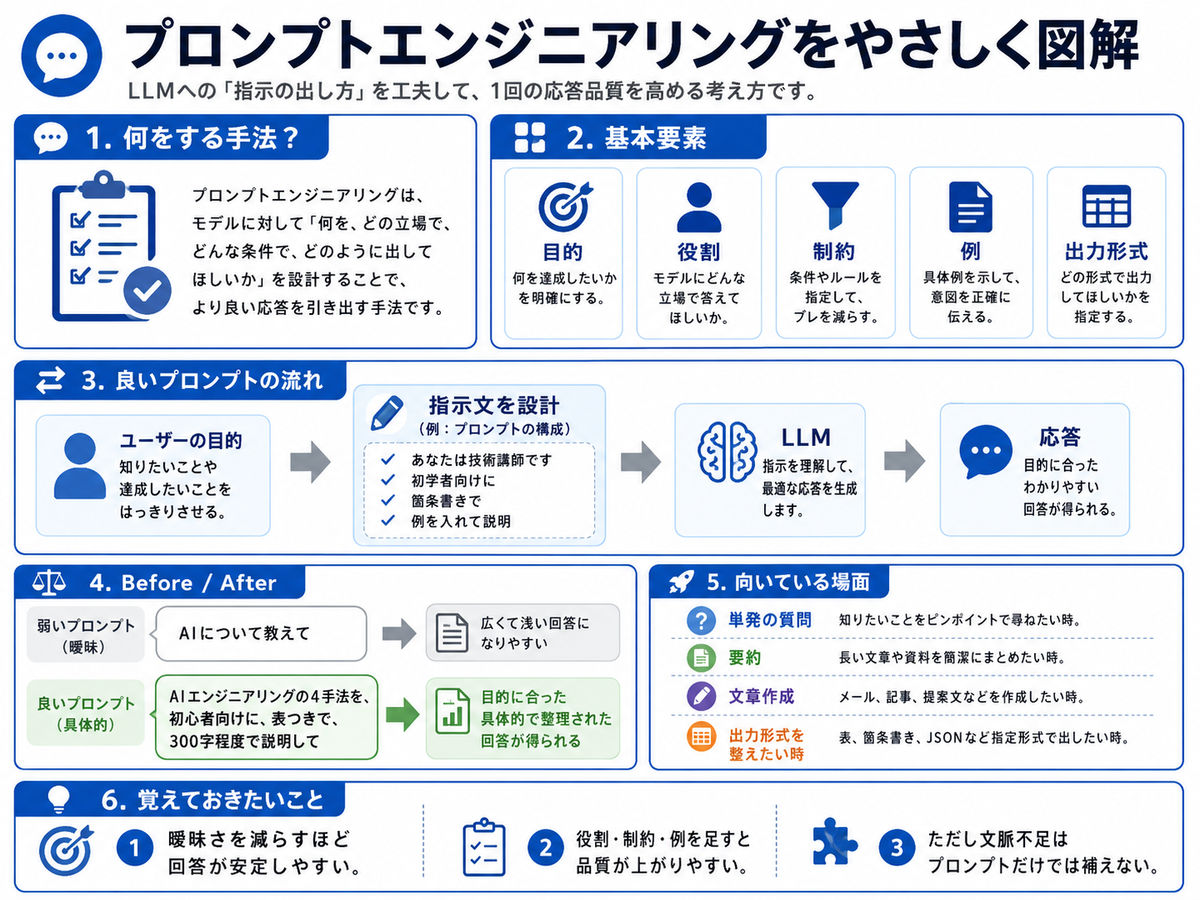
これは、LLM への「指示の出し方」を工夫して、1 回の応答品質を高める考え方です。モデルに対して「何を、どの立場で、どんな条件で、どのように出してほしいか」を設計することで、より良い応答を引き出します。
基本要素
良いプロンプトは、おおむね次の要素を意識して組み立てます。
| 要素 | 役割 |
|---|---|
| 目的 | 何を達成したいかを明確にする |
| 役割 | モデルにどんな立場で答えてほしいかを与える |
| 制約 | 条件やルールを指定して、回答のブレを減らす |
| 例 | 具体例を示して、意図を正確に伝える |
| 出力形式 | どの形式(表・箇条書き・JSON など)で出力してほしいかを指定する |
Before / After
具体的にどう変わるのか、悪い例と良い例を比べてみます。
- 弱いプロンプト(曖昧):「AI について教えて」
- → 広くて浅い回答になりやすい
- 良いプロンプト(具体的):「AI エンジニアリングの 4 手法を、初心者向けに、表つきで、300 字程度で説明して」
- → 目的に合った、具体的で整理された回答が得られる
このように、役割・制約・例・出力形式を足していくほど、回答が安定しやすくなります。
向いている場面と限界
単発の質問、要約、文章作成、出力形式を整えたい場面などに向いています。
ただし、プロンプトエンジニアリングには限界もあります。それは、文脈不足はプロンプトの工夫だけでは補えないという点です。「そもそもモデルが知らない情報」を引き出すことはできません。そこで次の手法が必要になります。
2. コンテキストエンジニアリング
2 つ目は コンテキストエンジニアリングです。
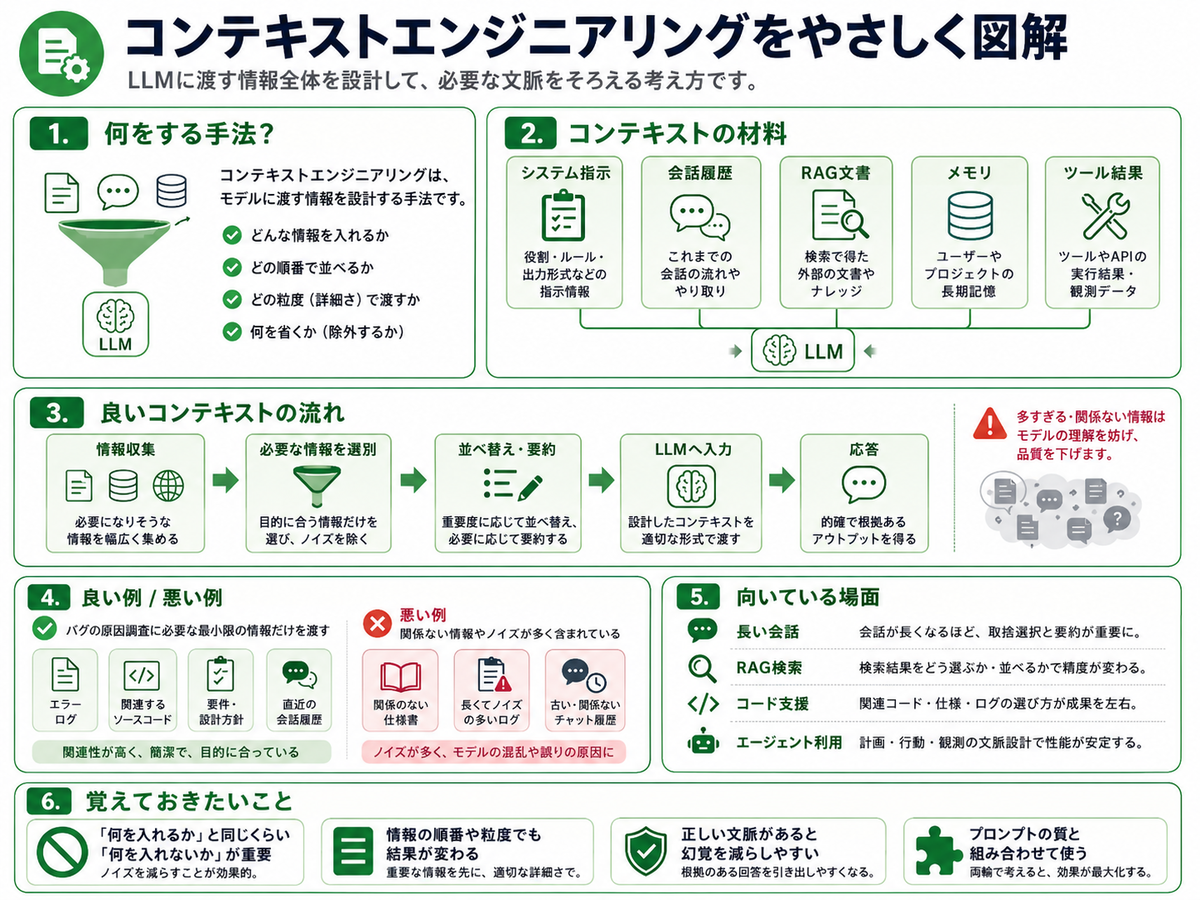
これは、LLM に渡す情報全体を設計して、必要な文脈をそろえる考え方です。プロンプト(指示文)だけでなく、モデルに渡す情報そのものに目を向けます。
コンテキストの材料
モデルに渡せる情報には、たとえば次のようなものがあります。
| 材料 | 内容 |
|---|---|
| システム指示 | 役割・ルール・出力形式などの指示情報 |
| 会話履歴 | これまでの会話の流れややり取り |
| RAG 文書 | 検索で得た外部の文書やナレッジ |
| メモリ | ユーザーやプロジェクトの長期記憶 |
| ツール結果 | ツールや API の実行結果・観測データ |
これらをただ詰め込むのではなく、「何を入れるか」と同じくらい「何を入れないか」を設計するのがコンテキストエンジニアリングの肝です。
設計で意識すること
具体的には、次の 4 点を意識します。
- どんな情報を入れるか
- どの順番で並べるか
- どの粒度(詳細さ)で渡すか
- 何を省くか(除外するか)
良い流れは「情報収集 → 必要な情報を選別 → 並べ替え・要約 → LLM へ入力 → 応答」となります。逆に、関係ない情報やノイズが多すぎると、モデルの理解を妨げて品質を下げます。バグの原因調査であれば、エラーログ・関連するソースコード・要件などに絞り、無関係な仕様書や古い履歴は省く、といった具合です。
ポイント
- 「何を入れるか」と同じくらい「何を入れないか」が重要(ノイズを減らす)
- 情報の順番や粒度でも結果が変わる
- 正しい文脈があると、幻覚(ハルシネーション)を減らしやすい
- プロンプトの質と組み合わせて使うと、効果が最大化する
3. ハーネスエンジニアリング
3 つ目は ハーネスエンジニアリングです。聞き慣れない言葉かもしれませんが、ハーネス(harness)は「装具・制御の仕組み」といった意味合いです。
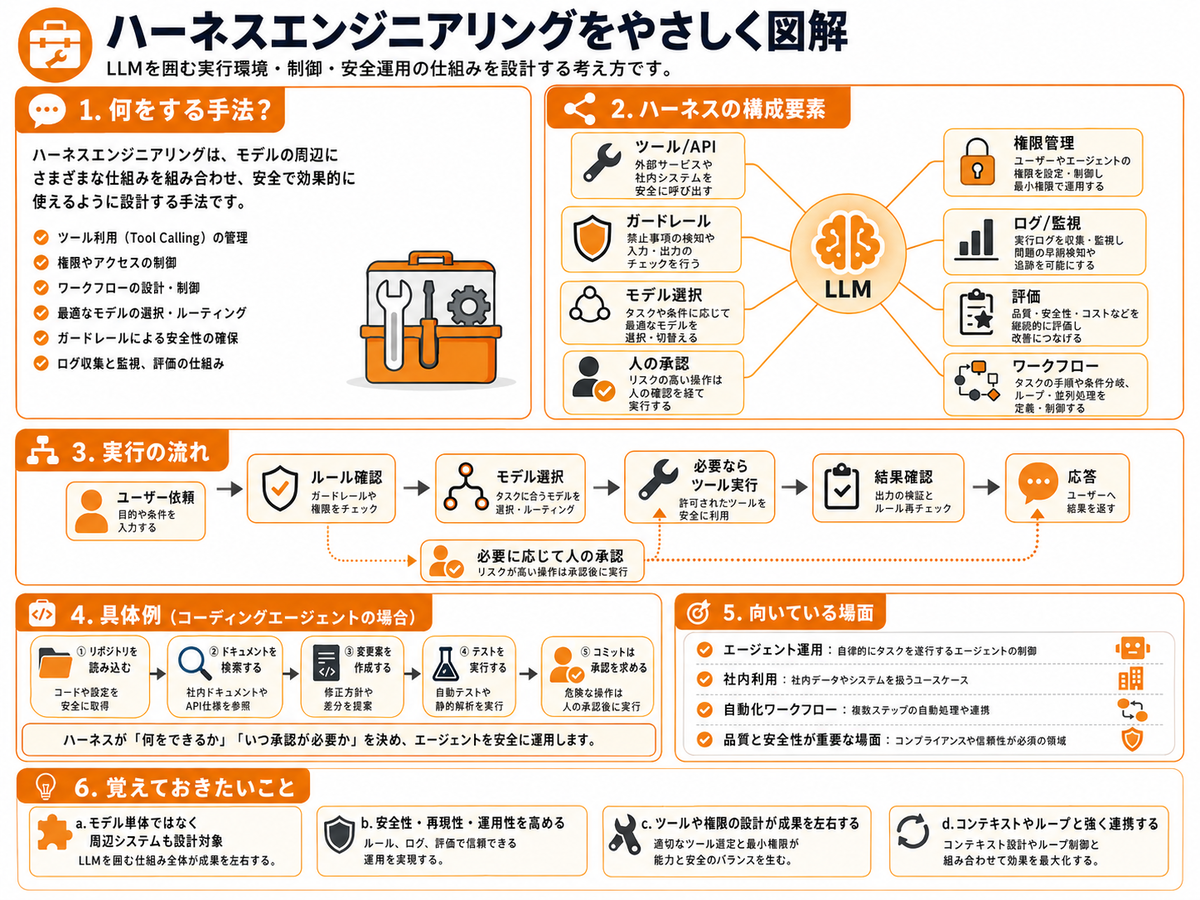
これは、LLM を囲む実行環境・制御・安全運用の仕組みを設計する考え方です。モデル単体ではなく、その周辺システム全体を設計対象にします。
ハーネスの構成要素
LLM の周りには、安全で効果的に使うための仕組みを組み合わせます。
| 構成要素 | 役割 |
|---|---|
| ツール / API | 外部サービスや社内システムを安全に呼び出す |
| ガードレール | 禁止事項の検知や、入力・出力のチェックを行う |
| モデル選択 | タスクや条件に応じて最適なモデルを選択・切り替える |
| 人の承認 | リスクの高い操作は人の確認を経て実行する |
| 権限管理 | ユーザーやエージェントの権限を最小権限で運用する |
| ログ / 監視 | 実行ログを収集・監視し、問題の早期検知を可能にする |
| 評価 | 品質・安全性・コストなどを継続的に評価し改善につなげる |
| ワークフロー | 手順や条件分岐、ループ・並列処理を定義・制御する |
実行の流れ
たとえばエージェントが動くときは、次のような流れを「仕組み」として用意しておきます。
- ユーザー依頼(目的や条件を入力)
- ルール確認(ガードレールや権限をチェック)
- モデル選択(タスクに合うモデルを選択・ルーティング)
- 必要ならツール実行(許可されたツールを安全に利用)
- 結果確認(出力の検証とルール再チェック)
- 応答(ユーザーへ結果を返す)
リスクが高い操作については、途中に「人の承認」を挟みます。コーディングエージェントを例にすると、「リポジトリを読み込む → ドキュメントを検索する → 変更案を作成する → テストを実行する → コミットは承認を求める」のように、何を自動でやってよいか/いつ承認が必要かを仕組みとして決めておくイメージです。
ポイント
- モデル単体ではなく、周辺システムも設計対象にする
- ルール・ログ・評価で、安全性・再現性・運用性を高める
- 適切なツール選定と最小権限が、能力と安全のバランスを生む
- コンテキストやループと強く連携して効果を最大化する
4. ループエンジニアリング
4 つ目は ループエンジニアリングです。
これは、モデルを一度きりで終わらせず、計画 → 実行 → 観察 → 改善の反復ループを設計して、複雑な課題を解く考え方です。
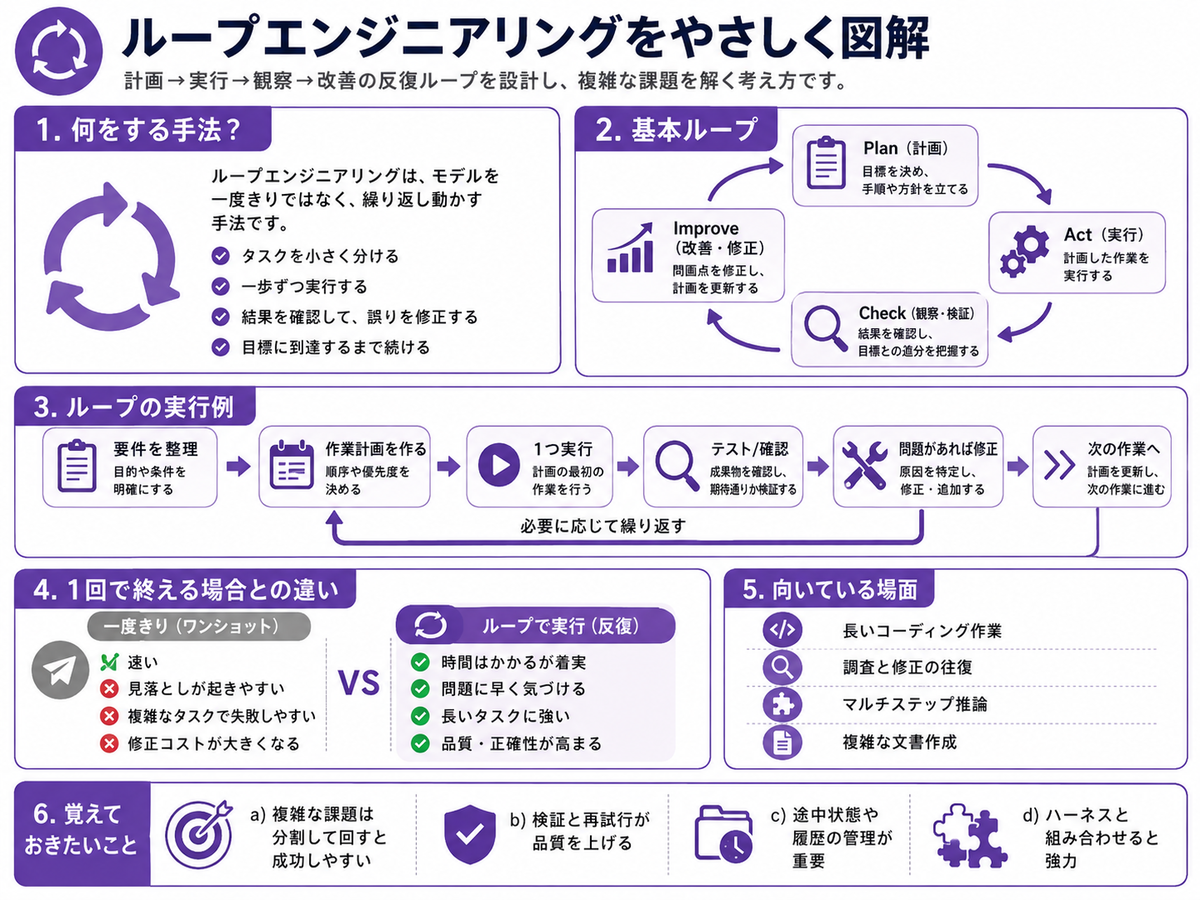
基本ループ
いわゆる PDCA に近い、次のサイクルを回します。
| ステップ | 内容 |
|---|---|
| Plan(計画) | 目標を決め、手順や方針を立てる |
| Act(実行) | 計画した作業を実行する |
| Check(観察・検証) | 結果を確認し、目標との差分を把握する |
| Improve(改善・修正) | 問題点を修正し、計画を更新する |
実際の流れとしては、「要件を整理 → 作業計画を作る → 1 つ実行 → テスト / 確認 → 問題があれば修正 → 次の作業へ」を、目標に到達するまで必要に応じて繰り返します。
一度きり(ワンショット)との違い
| 一度きり(ワンショット) | ループで実行(反復) | |
|---|---|---|
| 速さ | 速い | 時間はかかるが着実 |
| 見落とし | 起きやすい | 問題に早く気づける |
| 複雑なタスク | 失敗しやすい | 長いタスクに強い |
| 品質 | 修正コストが大きくなりがち | 品質・正確性が高まる |
ポイント
- 複雑な課題は分割して回すと成功しやすい
- 検証と再試行が品質を上げる
- 途中状態や履歴の管理が重要(前回触れたコンテキストウィンドウとも関わります)
- ハーネスと組み合わせると強力
長いコーディング作業、調査と修正の往復、マルチステップ推論、複雑な文書作成などで特に効果を発揮します。
5. コーディングエージェントでの実践(4 手法の結びつき)
最後に、これら 4 手法が実際にどう組み合わさるのかを、身近な例であるコーディングエージェント(GitHub Copilot / Codex / Claude Code など)で見てみます。
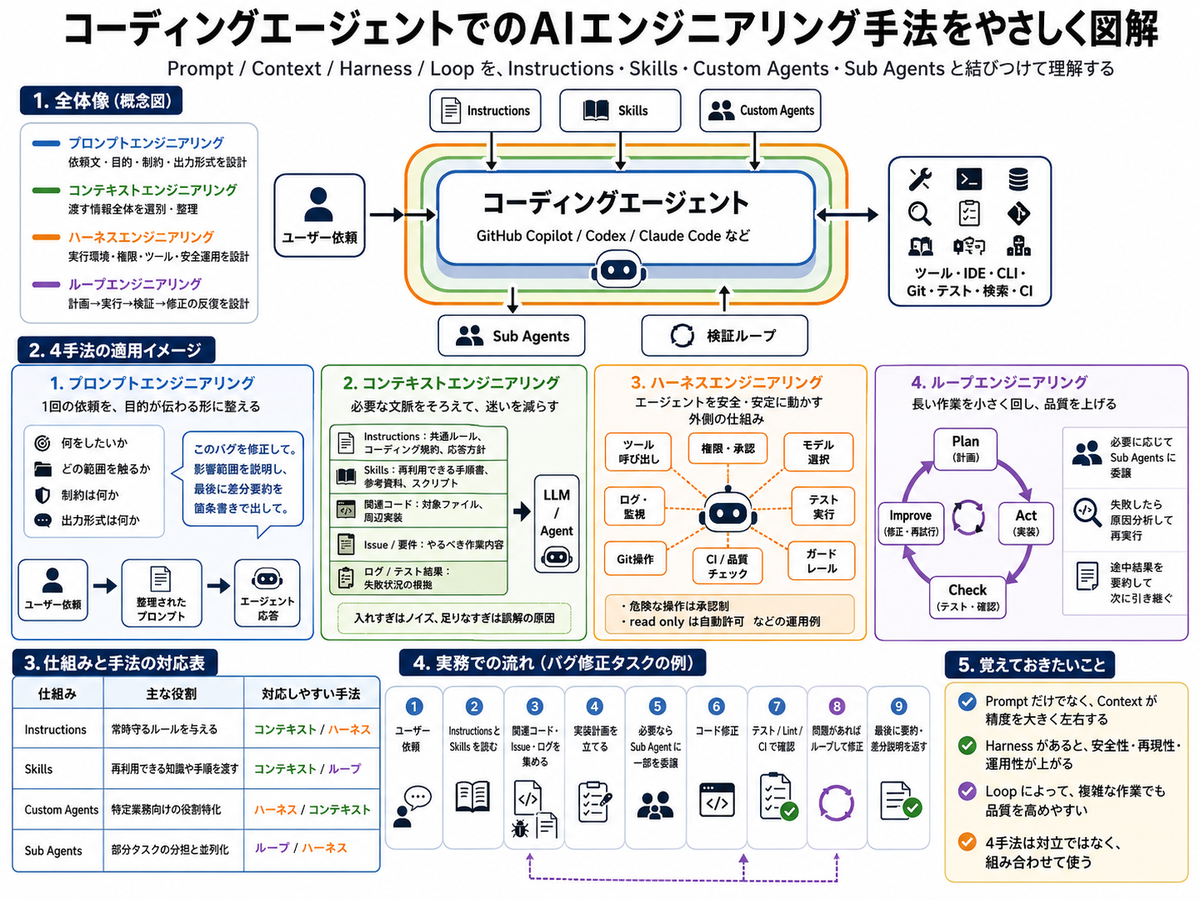
コーディングエージェントでは、4 手法が次のような形で現れます。
- プロンプトエンジニアリング:1 回の依頼を、目的が伝わる形に整える(何をしたいか/どの範囲を触るか/制約/出力形式)
- コンテキストエンジニアリング:必要な文脈をそろえて迷いを減らす(共通ルールや規約、参考資料、関連コード、Issue・要件、ログやテスト結果など)
- ハーネスエンジニアリング:エージェントを安全・安定に動かす外側の仕組み(ツール呼び出し、権限・承認、モデル選択、テスト実行、CI / 品質チェック、ガードレールなど)
- ループエンジニアリング:長い作業を小さく回し、品質を上げる(計画 → 実行 → 検証 → 修正の反復、失敗したら原因分析して再実行)
仕組みと手法の対応
最近のコーディングエージェントには、Instructions / Skills / Custom Agents / Sub Agents といった仕組みが備わっています。これらは 4 手法と次のように対応づけられます。
| 仕組み | 主な役割 | 対応しやすい手法 |
|---|---|---|
| Instructions | 常時守るルールを与える | コンテキスト / ハーネス |
| Skills | 再利用できる知識や手順を渡す | コンテキスト / ループ |
| Custom Agents | 特定業務向けの役割特化 | ハーネス / コンテキスト |
| Sub Agents | 部分タスクの分担と並列化 | ループ / ハーネス |
実務での流れ(バグ修正タスクの例)
実際のバグ修正は、4 手法を組み合わせて次のように進みます。
- ユーザー依頼
- Instructions と Skills を読む
- 関連コード・Issue・ログを集める
- 実装計画を立てる
- 必要なら Sub Agent に一部を委譲する
- コード修正
- テスト / Lint / CI で確認
- 問題があればループして修正
- 最後に要約・差分説明を返す
このように、プロンプトで依頼を整え、コンテキストで材料をそろえ、ハーネスで安全に動かし、ループで品質を高める——4 手法が自然に噛み合って 1 つの作業が完成します。
まとめ
今回は、LLM を使いこなすための AI エンジニアリング 4 手法を解説しました。最後に要点を振り返ります。
- プロンプトエンジニアリング:指示文を工夫して、1 回の応答品質を高める
- コンテキストエンジニアリング:渡す情報全体を設計し、必要な文脈をそろえる(「何を入れないか」も重要)
- ハーネスエンジニアリング:実行環境・制御・安全運用の仕組みを設計する
- ループエンジニアリング:計画 → 実行 → 観察 → 改善の反復で、複雑な課題を解く
全体を通して大事なのは、この 4 つは対立する選択肢ではなく、積み重ねて・組み合わせて使うものだということです。設計の焦点が「文章」から「システム全体」へ広がるにつれて、AI でできることも大きくなっていきます。
そして、その集大成的な実践の場が、コーディングエージェントのようなツールです。普段なにげなく使っている AI ツールの裏側で、これら 4 手法が働いていることを意識すると、より上手に使いこなせるようになるはずです。
LLM(Large Language Model:大規模言語モデル)の仕組み
まえがき
ChatGPT をはじめとする生成 AI が一気に身近になり、「とりあえず使ってはいるけれど、中で何が起きているのかはよく分からない」という方も多いのではないでしょうか。
私自身も組込みエンジニアとして、普段は機械語に近いレイヤを扱うことが多いのですが、最近は仕事でも生成 AI を使う場面が増えてきました。せっかくなので、LLM(Large Language Model:大規模言語モデル)の仕組みを、自分の理解の整理も兼ねて、できるだけやさしく図解しながらまとめてみることにしました。
今回はその第 1 回として、生成 AI の中心にある LLM そのものの仕組みを、次の 5 つのテーマに分けて解説します。
- LLM への入力の作り方(トークナイズとベクトル化)
- Transformer モデルとデコーダーの内部構造
- LLM はどう学習され、チャット AI になるのか
- Reasoning(推論)モデルとは
- コンテキストウィンドウとは
なお、本記事は数式や実装の厳密さよりも、全体像をイメージとしてつかむことを優先しています。細かい部分では「だいたいこういうこと」という割り切った説明をしているので、その点はご了承ください。
1. LLM への入力の作り方:トークナイズとベクトル化(埋め込み)
まず最初に押さえておきたいのが、LLM は人間が書いた文章をそのままでは扱えないという点です。
私たちが入力する「今日はいい天気ですね!」のような文章は、モデルにとってはただの文字の並びでしかありません。LLM は内部では数値計算しか行っていないため、文章を数値の形に変換してあげる必要があります。
その変換は、大きく トークナイズ(分割) と ベクトル化(埋め込み) の 2 段階で行われます。
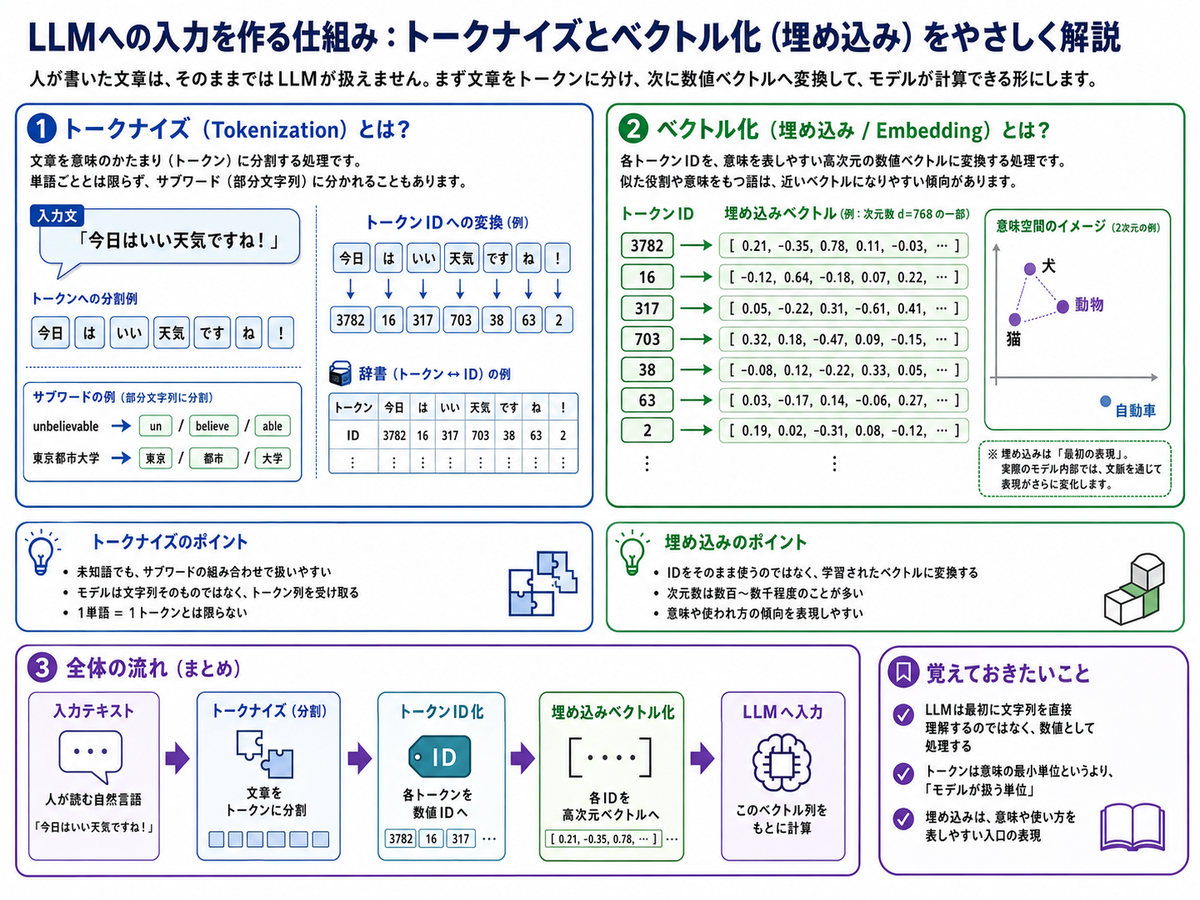
トークナイズ(Tokenization)とは
トークナイズとは、文章を トークンと呼ばれる意味のかたまりに分割する処理です。
たとえば「今日はいい天気ですね!」は、今日 / は / いい / 天気 / です / ね / ! のように分割されます。ここで注意したいのは、1 単語 = 1 トークンとは限らないという点です。
- 単語よりも細かい「サブワード(部分文字列)」に分かれることがある
- 例:
unbelievable→un/believe/able - 例:
東京都市大学→東京/都市/大学
- 例:
- 記号やスペースもトークンとして扱われる
分割されたトークンは、辞書を使って 今日 → 3782 のような トークン ID(数値) に変換されます。モデルは文字列そのものではなく、このトークン ID の列を受け取って処理します。
サブワードに分割する方式のおかげで、辞書に載っていない未知の単語でも、既知のサブワードの組み合わせとして扱えるのがポイントです。
ベクトル化(埋め込み / Embedding)とは
トークン ID はあくまで「単なる番号」であり、それ自体には意味の近さの情報がありません(ID が近いから意味も近い、というわけではない)。
そこで、各トークン ID を 意味を表しやすい高次元の数値ベクトルに変換します。これを 埋め込み(Embedding) と呼びます。
トークンID 3782 → [ 0.21, -0.35, 0.78, 0.11, -0.03, … ]
トークンID   16 → [ -0.12, 0.64, -0.18, 0.07, 0.22, … ]
このベクトルは、よく 数百〜数千次元もの大きさを持ちます。学習を通じて、似た役割や意味をもつ語が、近いベクトルになりやすいように調整されていきます。意味空間の中で「犬」と「猫」が近く、「自動車」が遠くに配置される、といったイメージです。
ただし、この埋め込みはあくまで「最初の表現」である点に注意してください。実際のモデル内部では、このあと文脈を通じて表現がさらに変化していきます(次の章で説明する Self-Attention がそれを担います)。
入力ができるまでの全体の流れ
ここまでを整理すると、LLM への入力は次の流れで作られます。
| ステップ | 内容 |
|---|---|
| ① 入力テキスト | 人が読む自然言語(「今日はいい天気ですね!」) |
| ② トークナイズ | 文章をトークンに分割 |
| ③ トークン ID 化 | 各トークンを数値 ID へ変換 |
| ④ 埋め込みベクトル化 | 各 ID を高次元ベクトルへ変換 |
| ⑤ LLM へ入力 | このベクトル列をもとに計算 |
ここで覚えておきたいのは、LLM は文字列を直接理解しているのではなく、すべて数値として処理しているということです。
2. Transformer モデルとデコーダーの内部構造
入力ができたところで、次は LLM の心臓部である Transformer の中身を見ていきます。
現代の多くの LLM は、「デコーダーのみ」の Transformer を何層も重ねた構造をしていて、その役割は一言でいえば 「次に来るトークンを予測すること」 です。
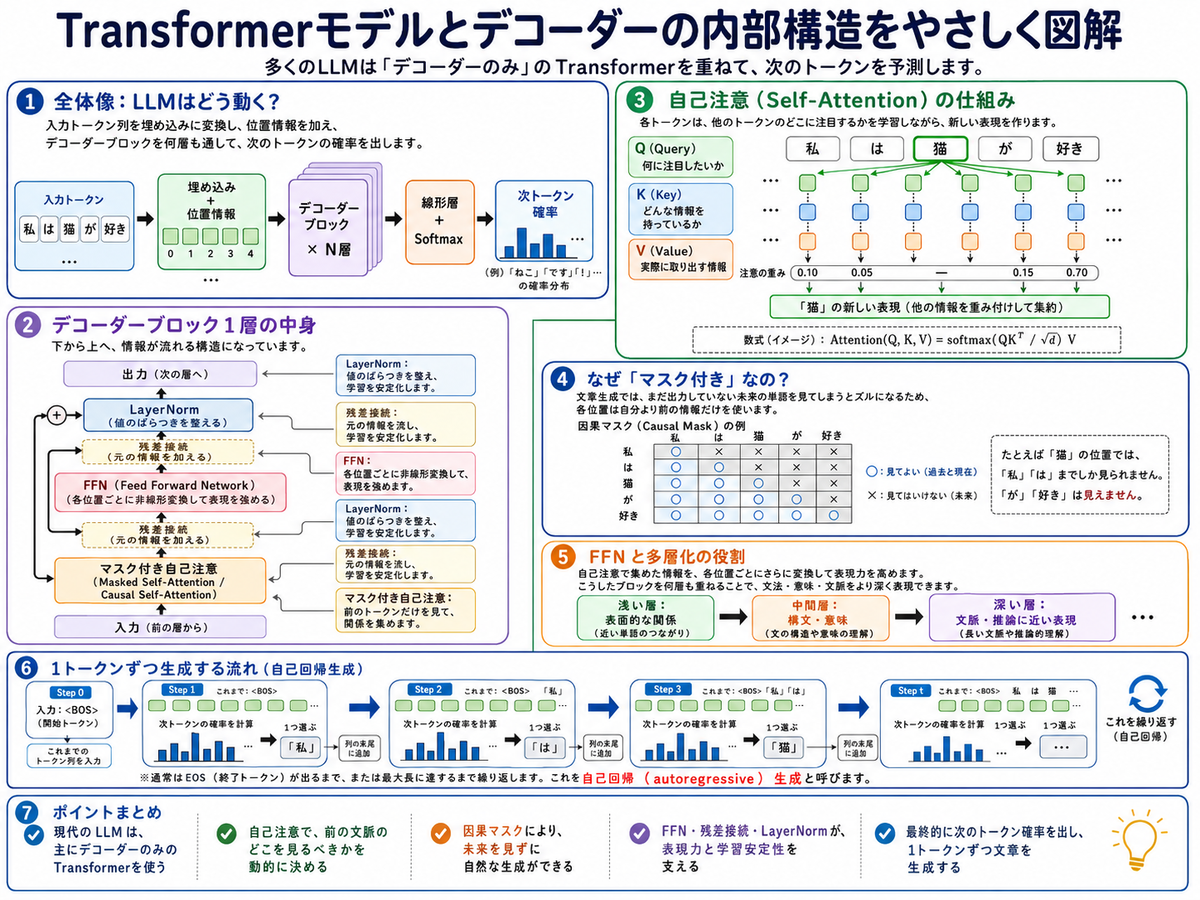
全体像:LLM はどう動くのか
大まかな流れは次のとおりです。
- 入力トークン列を埋め込みに変換する(前章の処理)
- 各トークンに位置情報を加える(語順を区別するため)
- デコーダーブロックを何層も通す
- 最後に線形層と Softmax を通して、次のトークンの確率分布を出す
最終的な出力は「次に来る単語の候補とその確率」です。たとえば「今日はいい天気ですね」に続くトークンとして、! の確率が高い、といった具合に計算されます。
デコーダーブロック 1 層の中身
1 つのデコーダーブロックは、下から上へと情報が流れる構造になっています。主な構成要素は次のとおりです。
| 構成要素 | 役割 |
|---|---|
| マスク付き自己注意(Masked Self-Attention) | 前のトークンだけを見て、関係を集める |
| 残差接続(Residual Connection) | 元の情報を流し、学習を安定化させる |
| LayerNorm | 値のばらつきを整え、学習を安定化させる |
| FFN(Feed Forward Network) | 各位置ごとに非線形変換して表現を強める |
ポイントは、Self-Attention で文脈の情報を集め、FFN で各トークンの表現を強めるという役割分担です。そして残差接続と LayerNorm が、層を深く重ねても学習が壊れないように支えています。
自己注意(Self-Attention)の仕組み
Transformer の最大の特徴が、この 自己注意(Self-Attention) です。
各トークンは、「他のトークンのどこに注目すべきか」を学習しながら、自分自身の新しい表現を作り直します。そのために、各トークンから次の 3 つの情報を作ります。
- Q(Query):何に注目したいか
- K(Key):どんな情報を持っているか
- V(Value):実際に取り出す情報
Query と Key を照らし合わせて「どこをどれだけ見るか(注意の重み)」を計算し、その重みで Value を集約することで、文脈を反映した新しい表現を作ります。イメージとしての数式は次のとおりです。
Attention(Q, K, V) = softmax( QKᵀ / √d ) V
たとえば「私 は 猫 が 好き」という文で「猫」の表現を作るとき、「私」「は」といった周囲のトークンの情報を重み付けして取り込む、というイメージです。
なぜ「マスク付き」なのか
文章生成では、まだ出力していない未来の単語を見てしまうとカンニング(ズル)になってしまうため、各位置は自分より前の情報だけを使うように制限します。これを 因果マスク(Causal Mask) と呼びます。
| 注目する位置\見られる対象 | 私 | は | 猫 | が | 好き |
|---|---|---|---|---|---|
| 私 | ○ | × | × | × | × |
| は | ○ | ○ | × | × | × |
| 猫 | ○ | ○ | ○ | × | × |
| が | ○ | ○ | ○ | ○ | × |
| 好き | ○ | ○ | ○ | ○ | ○ |
○ は「見てよい(過去と現在)」、× は「見てはいけない(未来)」を表します。たとえば「猫」の位置では「私」「は」までしか見られず、「が」「好き」は見えません。この仕組みによって、未来を見ずに自然な文章生成ができるようになります。
FFN と多層化の役割
Self-Attention で集めた文脈情報を、各位置ごとにさらに変換して表現力を高めるのが FFN(Feed Forward Network) です。
このデコーダーブロックを何層も重ねることで、扱える関係が段階的に深くなっていきます。
- 浅い層:表面的な関係(近い単語のつながり)
- 中間層:構文・意味(文の構造や意味の理解)
- 深い層:文脈・推論に近い表現(長い文脈や推論的な理解)
1 トークンずつ生成する流れ(自己回帰生成)
LLM が文章を作るときは、1 トークンずつ順番に生成していきます。
- これまでのトークン列を入力する
- 次トークンの確率を計算する
- その中から 1 つを選ぶ
- 選んだトークンを列の末尾に追加する
- 1 に戻って繰り返す
この「自分の出力を次の入力に使う」仕組みを 自己回帰(autoregressive)生成 と呼びます。通常は EOS(終了トークン) が出るまで、または最大長に達するまで繰り返されます。
ここまでをまとめると、現代の LLM は デコーダーのみの Transformer を使い、自己注意で文脈を捉え、因果マスクで未来を見ずに、1 トークンずつ次の単語を生成している、ということになります。
3. LLM はどう学習され、チャット AI になるのか
ここまでは「学習済みの LLM がどう動くか」を見てきました。次は、その LLM がどうやって作られ、私たちと自然に対話できる AI になるのかを見ていきます。
生のデータから始まり、段階的な学習と調整を経て、チャット AI が出来上がります。
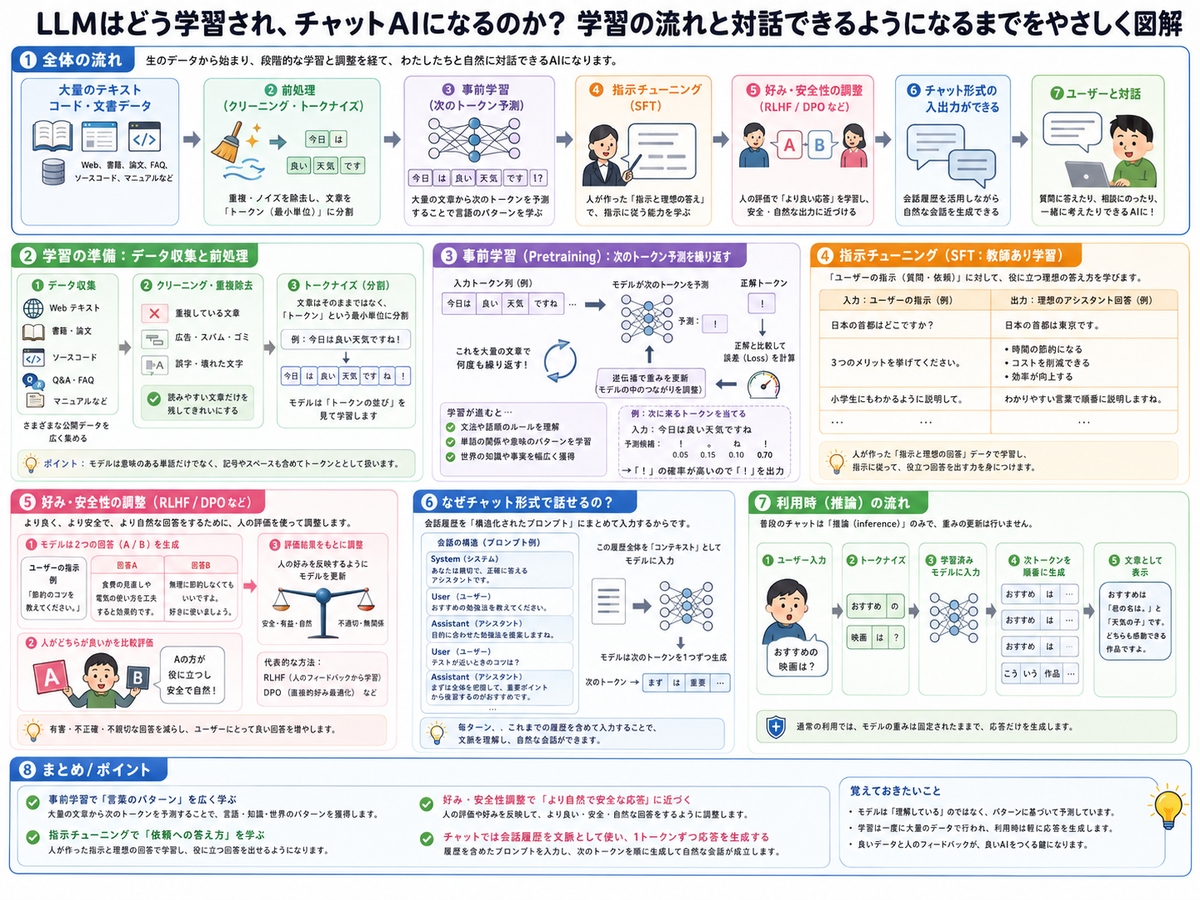
学習の準備:データ収集と前処理
まずは大量のテキスト(Web、書籍、論文、Q&A、ソースコード、マニュアルなど)を集めます。
集めたデータはそのまま使うのではなく、次のような前処理を行います。
- クリーニング・重複除去:重複している文章、広告・スパム、誤字・壊れた文字などを取り除き、読みやすい文章だけを残す
- トークナイズ:第 1 章で説明したとおり、文章をトークン(最小単位)に分割する
良いデータを用意することが、良い AI を作る出発点になります。
事前学習(Pretraining):次のトークン予測を繰り返す
前処理したデータを使って、モデルに 「次のトークンを予測する」 という学習をひたすら繰り返させます。これが 事前学習(Pretraining) です。
仕組みはシンプルで、「今日 は 良い 天気 ですね」の途中までを入力し、次に来るトークンを予測させ、正解とのズレ(誤差/Loss) を計算して、誤差が小さくなるようにモデル内部の重みを少しずつ更新していきます。
この「予測 → 答え合わせ → 重みの更新」を大量の文章で何度も繰り返すうちに、モデルは次第に、
- 文法や語順のルール
- 単語の関係や意味のパターン
- 世界の知識や事実
を幅広く獲得していきます。ここで大事なのは、モデルは内容を「理解」しているわけではなく、あくまで膨大なデータから学んだパターンに基づいて予測しているという点です。
指示チューニング(SFT:教師あり学習)
事前学習を終えただけのモデルは「文章の続きを書く」のは得意ですが、「ユーザーの指示に従って役立つ回答をする」のはまだ苦手です。
そこで、「ユーザーの指示(質問・依頼)」と「理想の答え」のペアを人が用意し、それを使って学習させます。これを 指示チューニング(SFT:Supervised Fine-Tuning) と呼びます。
| 入力:ユーザーの指示(例) | 出力:理想のアシスタント回答(例) |
|---|---|
| 日本の首都はどこですか? | 日本の首都は東京です。 |
| 3 つのメリットを挙げてください。 | ・時間の節約になる ・コストを削減できる ・効率が向上する |
| 小学生にもわかるように説明して。 | わかりやすい言葉で順番に説明しますね。 |
これによって、モデルは指示に従って役立つ回答を出す振る舞いを身につけます。
好み・安全性の調整(RLHF / DPO など)
さらに、より良く・より安全で・より自然な回答にするために、人の評価を使って調整を行います。代表的な手法が RLHF(人のフィードバックから学習) や DPO(直接的な好み最適化) です。
ざっくりとした流れは次のとおりです。
- モデルが 1 つの指示に対して 2 つの回答(A / B)を生成する
- 人がどちらが良いかを比較評価する
- 評価結果を反映するようにモデルを更新する
こうした調整によって、有害・不正確・不親切な回答を減らし、ユーザーにとって安全で自然な回答を増やしていきます。
なぜチャット形式で話せるのか
「過去のやり取りを踏まえて会話が続く」のは、会話履歴を「構造化されたプロンプト」にまとめて入力しているからです。
会話は次のような役割(ロール)で構造化されています。
- System(システム):どう振る舞うか、前提のルール
- User(ユーザー):ユーザーの入力・質問
- Assistant(アシスタント):モデルの応答
この履歴全体をコンテキストとしてモデルに入力し、モデルはそれを踏まえて次のトークンを 1 つずつ生成します。毎ターン、これまでの履歴を含めて入力することで、文脈を理解した自然な会話が成立しているわけです。
利用時(推論)の流れ
普段私たちが使っているチャットは 推論(inference)のみで、このときモデルの重みの更新は行われません。
- ユーザーが入力する
- トークナイズする
- 学習済みモデルに入力する
- 次トークンを順番に生成する
- 文章として表示する
つまり、学習は事前に大量のデータで行われ、利用時にはその固定された重みを使って応答だけを生成している、という関係になります。
4. Reasoning(推論)モデルとは
近年よく耳にするようになった Reasoning(推論)モデル についても触れておきます。
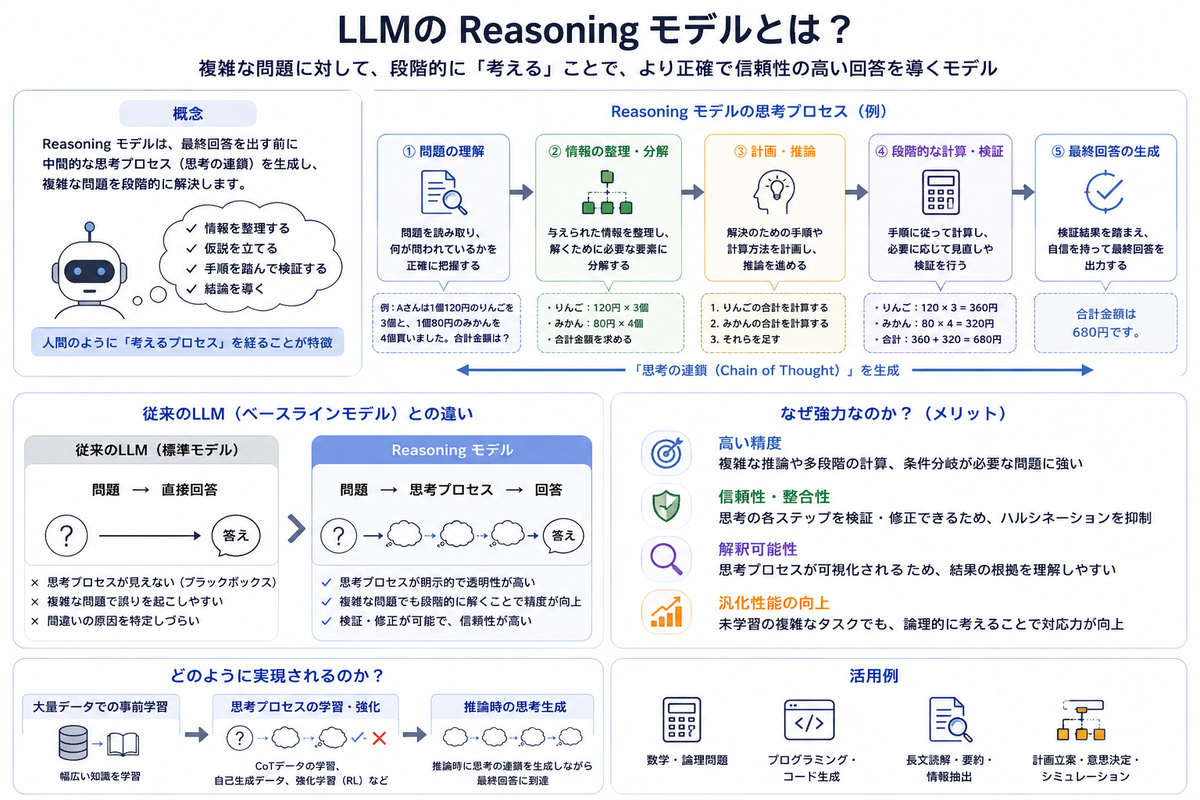
Reasoning モデルとは、複雑な問題に対して段階的に「考える」ことで、より正確で信頼性の高い回答を導くモデルです。
従来の LLM との違い
最大の違いは、最終回答を出す前に、中間的な思考プロセス(思考の連鎖)を生成する点です。
| 従来の LLM(標準モデル) | Reasoning モデル | |
|---|---|---|
| 流れ | 問題 → 直接回答 | 問題 → 思考プロセス → 回答 |
| 透明性 | 思考プロセスが見えない(ブラックボックス) | 思考プロセスが明示的で透明性が高い |
| 精度 | 複雑な問題で誤りを起こしやすい | 段階的に解くことで精度が向上 |
| 検証 | 間違いの原因を特定しづらい | 検証・修正が可能で信頼性が高い |
たとえば「1 個 120 円のりんごを 3 個と、1 個 80 円のみかんを 4 個買いました。合計金額は?」という問題に対して、いきなり答えるのではなく、
- 問題の理解:何が問われているかを正確に把握する
- 情報の整理・分解:りんご 120 円 × 3 個、みかん 80 円 × 4 個
- 計画・推論:合計金額を求める手順を立てる
- 段階的な計算・検証:120 × 3 = 360 円、80 × 4 = 320 円、合計 360 + 320 = 680 円
- 最終回答の生成:「合計金額は 680 円です」
というように、「思考の連鎖(Chain of Thought)」 を生成してから答えにたどり着きます。
なぜ強力なのか(メリット)
- 高い精度:複雑な推論や多段階の計算、条件分岐が必要な問題に強い
- 信頼性・整合性:思考の各ステップを検証・修正できるため、ハルシネーション(もっともらしい誤り)を抑制しやすい
- 解釈可能性:思考プロセスが可視化されるため、結果の根拠を理解しやすい
- 汎化性能の向上:未学習の複雑なタスクでも、論理的に考えることで対応力が上がる
どのように実現されるのか
Reasoning モデルは、おおよそ次のような過程で作られます。
- 大量データでの事前学習で幅広い知識を学ぶ
- 思考プロセスの学習・強化(CoT データの学習、自己生成データ、強化学習(RL)など)
- 推論時に思考の連鎖を生成しながら最終回答に到達する
数学・論理問題、プログラミング・コード生成、長文読解・要約、計画立案・意思決定といった、じっくり考える必要があるタスクで特に効果を発揮します。
5. コンテキストウィンドウとは
最後に、LLM を実際に使ううえで非常に重要な概念である コンテキストウィンドウ を取り上げます。
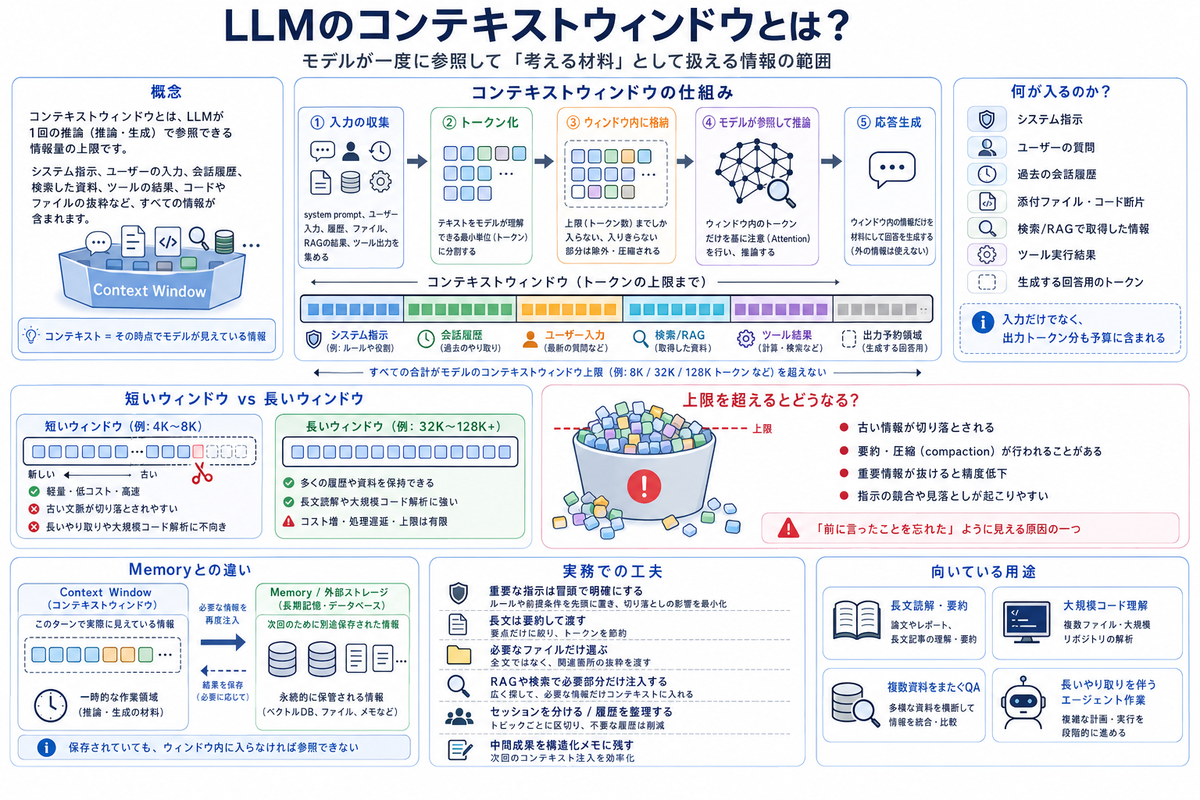
コンテキストウィンドウとは、モデルが 1 回の推論で参照して「考える材料」として扱える情報の範囲(量の上限) のことです。
何が入るのか
コンテキストウィンドウには、その時点でモデルが「見えている」情報がすべて含まれます。
- システム指示(ルールや役割)
- ユーザーの質問(最新の入力など)
- 過去の会話履歴
- 添付ファイル・コード断片
- 検索 / RAG で取得した情報
- ツールの実行結果
- 生成する回答用のトークン(出力予約領域)
ここで見落としがちなのが、入力だけでなく、これから生成する出力トークン分もこの上限に含まれるという点です。これらすべての合計が、モデルのコンテキストウィンドウ上限(例:8K / 32K / 128K トークンなど)を超えないようにする必要があります。
処理の流れとしては、入力を収集 → トークン化 → ウィンドウ内に格納 → モデルが参照して推論 → 応答生成、という形になります。ウィンドウ内のトークンだけを基に Attention を行うため、ウィンドウの外にある情報は使えません。
短いウィンドウ vs 長いウィンドウ
| 短いウィンドウ(例:4K〜8K) | 長いウィンドウ(例:32K〜128K+) | |
|---|---|---|
| 長所 | 軽量・低コスト・高速 | 多くの履歴や資料を保持できる/長文読解や大規模コード解析に強い |
| 短所 | 古い文脈が切り落とされやすい/長いやり取りや大規模コード解析に不向き | コスト増・処理遅延/上限は有限 |
上限を超えるとどうなる
入力が上限を超えると、次のようなことが起こります。
- 古い情報が切り落とされる
- 要約・圧縮(compaction)が行われることがある
- 重要情報が抜けると精度が低下する
- 指示の競合や見落としが起こりやすい
これは、対話を続けているうちに AI が 「前に言ったことを忘れた」ように見える原因の 1 つです。仕組みを知っていると、「会話が長くなってきたら要点を整理して伝え直す」といった対処がしやすくなります。
Memory との違い
コンテキストウィンドウと混同しやすいのが Memory(長期記憶 / 外部ストレージ) です。両者は別物です。
| コンテキストウィンドウ | Memory / 外部ストレージ | |
|---|---|---|
| 位置づけ | このターンで実際に見えている一時的な作業領域 | 次回のために別途保存された情報 |
| 永続性 | 推論・生成の材料(その場限り) | 永続的に保管(ベクトル DB、ファイル、メモなど) |
ポイントは、Memory に保存されていても、コンテキストウィンドウ内に取り込まれなければモデルは参照できないということです。必要な情報を Memory から「再注入」してはじめて、モデルはそれを使えるようになります。
実務での工夫
コンテキストウィンドウの制約とうまく付き合うための工夫をいくつか挙げておきます。
- 重要な指示は冒頭で明確にする:ルールや前提条件を先頭に置き、切り落としの影響を最小化する
- 長文は要約して渡す:要点だけに絞り、トークンを節約する
- 必要なファイルだけ選ぶ:全文ではなく、関連箇所の抜粋を渡す
- RAG や検索で必要部分だけ注入する:広く探して、必要な情報だけをコンテキストに入れる
- セッションを分ける/履歴を整理する:トピックごとに区切り、不要な履歴は減らす
- 中間成果を構造化メモに残す:次回のコンテキスト注入を効率化する
長文読解・要約、大規模コード理解、複数資料をまたぐ QA、長いやり取りを伴うエージェント作業など、扱う情報量が多い用途ほど、この工夫が効いてきます。
まとめ
今回は、生成 AI の中心にある LLM の仕組みを、5 つのテーマに分けて解説しました。最後に要点を振り返ります。
- 入力:LLM は文章を直接扱えないため、トークナイズで分割し、埋め込みベクトルへ変換して数値として処理する
- 内部構造:現代の LLM はデコーダーのみの Transformer を重ね、自己注意で文脈を捉え、因果マスクで未来を見ずに 1 トークンずつ生成する
- 学習:大量データでの事前学習で言語のパターンを学び、SFT で指示への従い方を、RLHF / DPO で好みと安全性を調整してチャット AI になる
- Reasoning モデル:思考の連鎖を生成してから答えることで、複雑な問題に強く、信頼性と解釈可能性が高い
- コンテキストウィンドウ:モデルが一度に参照できる情報量には上限があり、その制約を意識した使い方が重要
全体を通して大事なのは、LLM は内容を「理解」しているのではなく、膨大なデータから学んだパターンに基づいて、次のトークンを確率的に予測しているという点だと思います。この感覚を持っておくと、生成 AI の得意・不得意や、うまく使うためのコツが理解しやすくなるはずです。
次回は、この LLM を実際に活用するための手法(プロンプトエンジニアリングやコンテキストエンジニアリングなど)の進化について書いていく予定です。
【GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング】- 第11回「インスタンシングで同一形状を大量描画」
GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
第11回「インスタンシングで同一形状を大量描画」
- GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
はじめに
前回は バッチレンダリング を実装し、複数オブジェクトを1回のドローコールにまとめることで描画パフォーマンスを大幅に向上させました。
今回は インスタンシング(Instancing) を実装します。インスタンシングは、1つのベースジオメトリを N 個のインスタンスとして描画する 手法です。1000 個の立方体を 1 回のドローコールで描画しながら、CPUの負荷をバッチレンダリングよりもさらに抑えられます。
バッチレンダリング vs インスタンシング
前回のバッチレンダリングとの違いを整理しておきましょう。
| 方式 | ドローコール | CPU 負荷 | GPU 負荷 | 向いているケース |
|---|---|---|---|---|
| 個別描画 | N 回 | 低(1オブジェクト分) | 低 | 少数オブジェクト |
| バッチレンダリング | 1 回 | 高(頂点結合を毎フレーム実行) | 低 | 異なる形状の混在 |
| インスタンシング | 1 回 | 低(インスタンスデータのみ更新) | 低〜中 | 同一形状の大量描画 |
インスタンシングが得意なケース: - 草・木・石などの自然物 - パーティクルエフェクト - 星空・弾丸・敵キャラクターの群れ
インスタンシングの仕組み
インスタンシングの核心は 「同一の頂点データを繰り返しコピーしない」 という点にあります。
バッチレンダリング:
  頂点バッファ = [Cube0の頂点, Cube1の頂点, ... Cube999の頂点]
  → CPU で N 個分の変換行列を適用してから結合

インスタンシング:
  頂点バッファ = [Cube の頂点(1個分のみ)]  ← サイズは1個分
  インスタンスバッファ = [pos0, color0, scale0, pos1, color1, scale1, ...]
  → GPU が 1000 回同じ頂点データを読みつつ、インスタンスデータを切り替える
GPU には 「この頂点データを N 回描け。ただし毎回インスタンスデータを1つずつ進めろ」 という命令を1回送るだけです。
glVertexAttribDivisor とは
インスタンシングの鍵となる関数です。
# 通常の頂点属性: 1頂点ごとに進める(デフォルト、divisor = 0)
gl.glVertexAttribDivisor(location, 0)

# インスタンス属性: 1インスタンスごとに進める(divisor = 1)
gl.glVertexAttribDivisor(location, 1)
divisor = 1 を設定した属性は、1 インスタンスの描画が終わるごとに次の値に進みます。
glDrawElementsInstanced とは
# 通常の描画(1回分)
gl.glDrawElements(gl.GL_TRIANGLES, index_count, gl.GL_UNSIGNED_INT, None)

# インスタンシング描画(N インスタンス分、1回のコールで!)
gl.glDrawElementsInstanced(
    gl.GL_TRIANGLES,
    index_count,       # ベースジオメトリのインデックス数
    gl.GL_UNSIGNED_INT,
    None,
    instance_count     # インスタンス数
)
インスタンシング用シェーダー
インスタンシングでは専用の頂点シェーダーが必要です。インスタンス属性を受け取るために、新しい入力変数を追加します。
src/shaders/instanced.vert:
#version 330 core

// === 頂点属性(ベースジオメトリ、1頂点ごと) ===
layout (location = 0) in vec3 aPos;      // 頂点座標(ローカル空間)
layout (location = 1) in vec3 aColor;    // 頂点カラー(未使用)

// === インスタンス属性(1インスタンスごと)===
layout (location = 2) in vec3 aInstanceOffset;  // インスタンスの位置
layout (location = 3) in vec3 aInstanceColor;   // インスタンスのカラー
layout (location = 4) in float aInstanceScale;  // インスタンスのスケール

// Uniform変数(全インスタンス共通)
uniform mat4 model;       // グローバル変換行列(全体回転など)
uniform mat4 view;        // View行列
uniform mat4 projection;  // Projection行列

out vec3 vertexColor;

void main()
{
    // 1. ローカル座標にスケールを適用
    vec3 scaledPos = aPos * aInstanceScale;

    // 2. インスタンスのオフセット(位置)を加算 → ワールド座標
    vec3 worldPos = scaledPos + aInstanceOffset;

    // 3. グローバルmodel → View → Projectionで変換
    gl_Position = projection * view * model * vec4(worldPos, 1.0);

    // インスタンスカラーを使用
    vertexColor = aInstanceColor;
}
ポイント:
- Location 0, 1: 通常の頂点属性(ベースジオメトリ)
- Location 2, 3, 4: インスタンス属性(glVertexAttribDivisor(location, 1) が設定される)
- フラグメントシェーダー(basic.frag)はそのまま流用
InstanceRenderer クラスの実装
src/graphics/instance_renderer.py:
クラス設計
class InstanceRenderer:
    """
    インスタンスレンダリングクラス

    1つのベースジオメトリを N インスタンス分、1回のドローコールで描画する。

    インスタンスVBOの1要素 = 7 floats
      [offset.x, offset.y, offset.z, color.r, color.g, color.b, scale]
    """

    # インスタンスVBO内の各属性のオフセット
    _INSTANCE_STRIDE_FLOATS = 7
    _INSTANCE_OFFSET_OFFSET = 0   # vec3: x, y, z
    _INSTANCE_COLOR_OFFSET  = 3   # vec3: r, g, b
    _INSTANCE_SCALE_OFFSET  = 6   # float: scale

    def __init__(self) -> None:
        self._vao: int = 0
        self._vbo: int = 0           # ベース頂点バッファ
        self._ebo: int = 0           # インデックスバッファ(オプション)
        self._instance_vbo: int = 0  # インスタンスデータバッファ

        self._vertex_count: int = 0
        self._index_count: int = 0
        self._instance_count: int = 0
        self._use_indices: bool = False
バッファの設定
def set_geometry(self,
                 vertices: np.ndarray,
                 indices: Optional[np.ndarray] = None) -> None:
    """ベースジオメトリを設定する(1個分のみ)"""
    self._vertex_count = len(vertices)
    self._use_indices = indices is not None
    if indices is not None:
        self._index_count = len(indices)
    self._setup_vertex_buffers(vertices, indices)

def set_instances(self,
                  offsets: np.ndarray,
                  colors: np.ndarray,
                  scales: np.ndarray) -> None:
    """インスタンスデータを設定する"""
    instance_data = self._pack_instance_data(offsets, colors, scales)
    self._instance_count = len(offsets)
    self._setup_instance_buffer(instance_data)
インスタンスデータのパッキング
複数の配列を1つのインタリーブ配列に結合します。
def _pack_instance_data(self,
                        offsets: np.ndarray,
                        colors: np.ndarray,
                        scales: np.ndarray) -> np.ndarray:
    """
    インスタンス属性を1つのインタリーブ配列にパックする

    レイアウト(1インスタンス = 7 floats):
      [offset.x, offset.y, offset.z, color.r, color.g, color.b, scale]
    """
    n = len(offsets)
    scales_2d = scales.reshape(n, 1) if scales.ndim == 1 else scales
    instance_data = np.hstack([
        offsets.reshape(n, 3),
        colors.reshape(n, 3),
        scales_2d.reshape(n, 1),
    ]).astype(np.float32)
    return instance_data
頂点バッファの作成
def _setup_vertex_buffers(self,
                          vertices: np.ndarray,
                          indices: Optional[np.ndarray]) -> None:
    """ベース頂点バッファを作成する"""
    self.cleanup()  # 既存バッファを解放

    self._vao = gl.glGenVertexArrays(1)
    gl.glBindVertexArray(self._vao)

    # --- 頂点 VBO ---
    self._vbo = gl.glGenBuffers(1)
    gl.glBindBuffer(gl.GL_ARRAY_BUFFER, self._vbo)
    gl.glBufferData(
        gl.GL_ARRAY_BUFFER,
        vertices.nbytes,
        vertices.astype(np.float32),
        gl.GL_STATIC_DRAW
    )

    stride = 6 * vertices.itemsize  # 6 floats: x, y, z, r, g, b

    # Location 0: aPos (vec3)
    gl.glEnableVertexAttribArray(0)
    gl.glVertexAttribPointer(
        0, 3, gl.GL_FLOAT, gl.GL_FALSE,
        stride, gl.ctypes.c_void_p(0)
    )

    # Location 1: aColor (vec3)
    gl.glEnableVertexAttribArray(1)
    gl.glVertexAttribPointer(
        1, 3, gl.GL_FLOAT, gl.GL_FALSE,
        stride, gl.ctypes.c_void_p(3 * vertices.itemsize)
    )

    # --- EBO(インデックス使用の場合)---
    if indices is not None and indices.size > 0:
        self._ebo = gl.glGenBuffers(1)
        gl.glBindBuffer(gl.GL_ELEMENT_ARRAY_BUFFER, self._ebo)
        gl.glBufferData(
            gl.GL_ELEMENT_ARRAY_BUFFER,
            indices.nbytes,
            indices.astype(np.uint32),
            gl.GL_STATIC_DRAW
        )

    gl.glBindVertexArray(0)
インスタンスバッファの作成(ポイント!)
def _setup_instance_buffer(self, instance_data: np.ndarray) -> None:
    """
    インスタンスVBOを作成し、VAOに属性を登録する

    glVertexAttribDivisor(location, 1) により
    attribute が1インスタンスごとに進むように設定する。
    """
    self._instance_vbo = gl.glGenBuffers(1)
    gl.glBindBuffer(gl.GL_ARRAY_BUFFER, self._instance_vbo)
    gl.glBufferData(
        gl.GL_ARRAY_BUFFER,
        instance_data.nbytes,
        instance_data,
        gl.GL_DYNAMIC_DRAW  # 動的更新を想定
    )

    stride = self._INSTANCE_STRIDE_FLOATS * instance_data.itemsize  # 28 bytes

    gl.glBindVertexArray(self._vao)

    # Location 2: aInstanceOffset (vec3)
    offset_bytes = self._INSTANCE_OFFSET_OFFSET * instance_data.itemsize
    gl.glEnableVertexAttribArray(2)
    gl.glVertexAttribPointer(
        2, 3, gl.GL_FLOAT, gl.GL_FALSE,
        stride, gl.ctypes.c_void_p(offset_bytes)
    )
    gl.glVertexAttribDivisor(2, 1)  # ← 1インスタンスごとに進める!

    # Location 3: aInstanceColor (vec3)
    color_bytes = self._INSTANCE_COLOR_OFFSET * instance_data.itemsize
    gl.glEnableVertexAttribArray(3)
    gl.glVertexAttribPointer(
        3, 3, gl.GL_FLOAT, gl.GL_FALSE,
        stride, gl.ctypes.c_void_p(color_bytes)
    )
    gl.glVertexAttribDivisor(3, 1)

    # Location 4: aInstanceScale (float)
    scale_bytes = self._INSTANCE_SCALE_OFFSET * instance_data.itemsize
    gl.glEnableVertexAttribArray(4)
    gl.glVertexAttribPointer(
        4, 1, gl.GL_FLOAT, gl.GL_FALSE,
        stride, gl.ctypes.c_void_p(scale_bytes)
    )
    gl.glVertexAttribDivisor(4, 1)

    gl.glBindVertexArray(0)
    gl.glBindBuffer(gl.GL_ARRAY_BUFFER, 0)
glVertexAttribDivisor(location, 1) が重要:これを設定しないと、インスタンス属性が頂点ごとに進んでしまいます。
描画メソッド
def draw(self) -> None:
    """インスタンシング描画を実行する(1回のドローコール)"""
    if self._vao == 0 or self._instance_count == 0:
        return

    gl.glBindVertexArray(self._vao)

    if self._use_indices and self._index_count > 0:
        gl.glDrawElementsInstanced(
            gl.GL_TRIANGLES,
            self._index_count,
            gl.GL_UNSIGNED_INT,
            None,
            self._instance_count  # ← N個まとめて描画!
        )
    else:
        gl.glDrawArraysInstanced(
            gl.GL_TRIANGLES,
            0,
            self._vertex_count,
            self._instance_count
        )

    gl.glBindVertexArray(0)
動的更新(アニメーション対応)
def update_instances(self,
                     offsets: np.ndarray,
                     colors: np.ndarray,
                     scales: np.ndarray) -> None:
    """インスタンスデータを更新する(毎フレーム呼び出し可能)"""
    instance_data = self._pack_instance_data(offsets, colors, scales)
    new_count = len(offsets)

    if new_count != self._instance_count:
        # インスタンス数が変わった場合はバッファを再確保
        self._instance_count = new_count
        gl.glBindBuffer(gl.GL_ARRAY_BUFFER, self._instance_vbo)
        gl.glBufferData(
            gl.GL_ARRAY_BUFFER,
            instance_data.nbytes,
            instance_data,
            gl.GL_DYNAMIC_DRAW
        )
    else:
        # サイズが同じなら部分更新(高速)
        gl.glBindBuffer(gl.GL_ARRAY_BUFFER, self._instance_vbo)
        gl.glBufferSubData(    # ← メモリ再確保なし、高速!
            gl.GL_ARRAY_BUFFER,
            0,
            instance_data.nbytes,
            instance_data
        )

    gl.glBindBuffer(gl.GL_ARRAY_BUFFER, 0)
glBufferSubData を使うことで、バッファのメモリ再確保なしにデータだけ更新できます。これがアニメーション時のパフォーマンスを維持するコツです。
App への組み込み
src/core/app.py でインスタンシングデモを追加します。
初期化
def __init__(self) -> None:
    # ... 既存の初期化 ...

    # インスタンシングデモ
    self._instanced_shader: Shader | None = None
    self._instance_renderer: InstanceRenderer | None = None
    self._instance_count_x = 20         # X方向のグリッド数
    self._instance_count_z = 20         # Z方向のグリッド数
    self._instance_spacing = 2.0        # インスタンス間隔
    self._instance_scale = 0.6          # スケール
    self._instance_wave_amplitude = 2.0 # 波の振幅(Y方向)
    self._instance_wave_speed = 1.0     # 波のアニメーション速度
    self._instance_wave_time = 0.0      # 経過時間
    self._instance_animate = True       # アニメーション有効
    self._instance_shape = 0            # 0: Cube, 1: Sphere
    self._setup_instanced_shader()
    self._setup_instancing()
インスタンスデータの生成(サイン波グリッド)
def _generate_instance_data(
    self,
    time: float = 0.0
) -> tuple[np.ndarray, np.ndarray, np.ndarray]:
    """グリッド状にインスタンスを配置し、Y方向にサイン波を適用"""
    nx = self._instance_count_x
    nz = self._instance_count_z
    n = nx * nz
    spacing = self._instance_spacing

    center_x = (nx - 1) * spacing * 0.5
    center_z = (nz - 1) * spacing * 0.5

    offsets = np.zeros((n, 3), dtype=np.float32)
    colors  = np.zeros((n, 3), dtype=np.float32)
    scales  = np.full(n, self._instance_scale, dtype=np.float32)

    for iz in range(nz):
        for ix in range(nx):
            idx = iz * nx + ix
            x = ix * spacing - center_x
            z = iz * spacing - center_z

            # 波形でY方向に高さを付ける
            dist = np.sqrt(x * x + z * z)
            y = np.sin(dist * 0.5 - time * self._instance_wave_speed) \
                * self._instance_wave_amplitude

            offsets[idx] = [x, y, z]

            # 高さに応じたカラーグラデーション(青→緑→赤)
            t = (y / (self._instance_wave_amplitude + 1e-6) + 1.0) * 0.5
            colors[idx] = [t, 0.3 + 0.4 * t, 1.0 - t]

    return offsets, colors, scales
描画処理
def _draw_instancing_demo(self) -> None:
    """インスタンシングを使用して大量オブジェクトを描画する"""
    if not self._instanced_shader or not self._instance_renderer:
        return

    # アニメーション中はインスタンスデータを毎フレーム更新
    if self._instance_animate:
        offsets, colors, scales = self._generate_instance_data(
            self._instance_wave_time
        )
        with performance_manager.time_operation("Update Instance Data"):
            self._instance_renderer.update_instances(offsets, colors, scales)

    self._instanced_shader.use()

    camera = self._camera_3d if self._use_3d_camera else self._camera_2d

    # グローバルModel行列(回転スライダー対応)
    self._transform.set_model_identity()
    self._transform.rotate_model_x(self._rotation_x)
    self._transform.rotate_model_y(self._rotation_y)
    self._transform.rotate_model_z(self._rotation_z)

    self._instanced_shader.set_mat4("model", self._transform.model)
    self._instanced_shader.set_mat4("view", camera.view_matrix)
    self._instanced_shader.set_mat4("projection", camera.projection_matrix)

    with performance_manager.time_operation("Draw Instanced"):
        self._instance_renderer.draw()  # ← 1回のドローコール!

    performance_manager.set_draw_call_count(1)
imgui でパラメータを操作

スクリーンショットの計測値(924インスタンス、28×33グリッド):
| 項目 | 値 |
|---|---|
| FPS | 120.1 |
| Frame Time | 8.33 ms |
| Draw Calls | 1 |
| Update Instance Data | 0.10 ms |
| Draw Instanced | 0.06 ms |
Instancing ウィンドウから以下を操作できます:
| パラメータ | 説明 |
|---|---|
| Grid X / Z | X・Z 方向のインスタンス数(最大 50x50 = 2500) |
| Spacing | インスタンス間の間隔 |
| Scale | 各インスタンスのスケール |
| Animate | 波アニメーションの ON/OFF |
| Amplitude | 波の高さ |
| Speed | 波のアニメーション速度 |
| Shape | Cube / Sphere の切り替え |
Draw Calls が常に 1 であることを Performance ウィンドウで確認できます。
ユニットテスト
tests/test_instance_renderer.py に 19 個のテストを追加しました。
class TestInstanceRendererPackData:
    """_pack_instance_data のテスト"""

    def test_pack_basic(self):
        """基本的なパッキング"""
        renderer = InstanceRenderer()

        offsets = np.array([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]], dtype=np.float32)
        colors  = np.array([[1.0, 0.0, 0.0], [0.0, 1.0, 0.0]], dtype=np.float32)
        scales  = np.array([0.5, 0.8], dtype=np.float32)

        data = renderer._pack_instance_data(offsets, colors, scales)

        assert data.shape == (2, 7)
        assert data.dtype == np.float32

        # 1番目のインスタンス
        np.testing.assert_array_almost_equal(data[0, :3], [1.0, 2.0, 3.0])  # offset
        np.testing.assert_array_almost_equal(data[0, 3:6], [1.0, 0.0, 0.0]) # color
        assert data[0, 6] == pytest.approx(0.5)                              # scale
OpenGL 呼び出しはモックで検証:
def test_draw_calls_instanced(self):
    """draw() が glDrawElementsInstanced を呼ぶ"""
    with patch('src.graphics.instance_renderer.gl') as mock_gl:
        renderer = InstanceRenderer()
        renderer._vao = 1
        renderer._use_indices = True
        renderer._index_count = 36
        renderer._instance_count = 100

        renderer.draw()

        mock_gl.glDrawElementsInstanced.assert_called_once_with(
            mock_gl.GL_TRIANGLES,
            36,
            mock_gl.GL_UNSIGNED_INT,
            None,
            100
        )
実行方法と動作確認
# 仮想環境を有効化
source .venv/bin/activate

# 起動
python -m src.main
- Display Mode を
Instancingに切り替え - グリッド(20x20 = 400 個)の立方体がサイン波アニメーションで動く
- Performance ウィンドウ で Draw Calls: 1 を確認
- Grid X / Z を 50x50(2500 個)に増やしても Draw Calls は 1 のまま
バッチレンダリングとの比較まとめ
| バッチレンダリング | インスタンシング | |
|---|---|---|
| ドローコール | 1 回 | 1 回 |
| CPU 負荷(静的) | 低(build 済み) | 低 |
| CPU 負荷(動的) | 高(毎フレーム頂点結合) | 低(インスタンスデータのみ) |
| GPU メモリ | N × 頂点データ | 1 × 頂点データ + N × インスタンスデータ |
| 異なる形状の混在 | 可 | 不可(同一形状のみ) |
| インスタンス数の上限 | GPU VRAM による | GPU VRAM による(インスタンスデータが小さい分だけ余裕) |
結論: 同一形状を大量に描画する場合は インスタンシング が最善策。異なる形状を混在させたい場合は バッチレンダリング を使いましょう。
まとめ
今回実装したものと学んだこと:
実装内容
- インスタンシング用頂点シェーダー (
instanced.vert)- Location 2, 3, 4 でインスタンス属性を受け取る
- InstanceRenderer クラス (
instance_renderer.py)glVertexAttribDivisorでインスタンス属性を設定glDrawElementsInstancedで 1 ドローコール描画glBufferSubDataで高速な動的更新
- サイン波グリッドデモ (
app.py)- 400〜2500 個の立方体/球体をアニメーション
- imgui でパラメータをリアルタイム調整
学んだこと
- インスタンシングはドローコール削減とCPU負荷削減を両立 できる
glVertexAttribDivisor(location, 1)が per-instance 属性の核心glBufferSubDataで動的更新時もバッファ再確保のコストを避けられる- 同一形状の大量描画では インスタンシング > バッチレンダリング
次回はテクスチャマッピングに進みます。お楽しみに!
次回: 第12回「テクスチャマッピング」(準備中)
この記事のコード: GitHub - PythonOpenGL Phase 7b
【GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング】 - 第10回「バッチレンダリングで描画を高速化」
GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
第10回「バッチレンダリングで描画を高速化」
- GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
はじめに
前回は、立方体や球体といった複雑な形状をEBO(Element Buffer Object)を使って効率的に描画する方法を学びました。
今回は、バッチレンダリング(Batch Rendering)を実装して、描画パフォーマンスを大幅に向上させる方法を学びます。複数のオブジェクトを1回のドローコールでまとめて描画することで、ドローコールを劇的に削減し、FPSを大幅に向上させることができます。
また、パフォーマンス計測のためのPerformanceManagerも実装し、最適化の効果を定量的に評価できるようにします。
なぜバッチレンダリングが必要なのか?
ドローコールのコスト
現在の実装では、各オブジェクトごとに個別の描画命令(ドローコール)を発行しています:
# 従来の方法:各オブジェクトで個別にdraw()
for obj in objects:
    transform.set_model_identity()
    transform.translate(obj['pos'])
    transform.scale(obj['scale'])
    shader.set_mat4("model", transform.model)
    geometry.draw()  # ← ドローコール発生
問題点:
- オブジェクト数に比例してドローコールが増加
- CPU-GPU間の通信オーバーヘッドが大きい
- 現代のGPUは少数の大きな描画を得意とする
パフォーマンス計測基盤の実装
最適化の効果を測定するため、まずパフォーマンス計測の仕組みを実装します。
PerformanceManager クラス
src/utils/performance.py:
from dataclasses import dataclass
from typing import Dict, Optional
import time

@dataclass
class PerformanceStats:
    """パフォーマンス統計情報"""
    fps: float
    frame_time_ms: float
    timing_stats: Dict[str, float]
    hierarchical_stats: Dict[str, any]

class PerformanceManager:
    """パフォーマンス計測マネージャー"""

    def __init__(self):
        self._frame_times: list[float] = []
        self._timing_stats: Dict[str, float] = {}
        self._operation_stack: list[tuple[str, float]] = []
        self._draw_call_count: int = 0
        self._current_fps: float = 0.0

    def begin_frame(self) -> None:
        """フレーム開始"""
        self._frame_start_time = time.time()
        self._timing_stats.clear()
        self._draw_call_count = 0

    def end_frame(self) -> None:
        """フレーム終了"""
        frame_time = time.time() - self._frame_start_time
        self._frame_times.append(frame_time)

        # 10フレームごとにFPS計算
        if len(self._frame_times) >= 10:
            avg_time = sum(self._frame_times[-10:]) / 10
            self._current_fps = 1.0 / avg_time if avg_time > 0 else 0.0

    def time_operation(self, name: str):
        """処理時間計測用コンテキストマネージャー"""
        return OperationTimer(self, name)

    def set_draw_call_count(self, count: int) -> None:
        """ドローコール数を記録"""
        self._draw_call_count = count
OperationTimer コンテキストマネージャー
class OperationTimer:
    """処理時間計測用コンテキストマネージャー"""

    def __init__(self, manager: PerformanceManager, name: str):
        self._manager = manager
        self._name = name
        self._start_time = 0.0

    def __enter__(self):
        self._start_time = time.time()
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        elapsed = time.time() - self._start_time
        self._manager._record_operation(self._name, elapsed)
        return False
使用例
# App.pyのメインループ
def run(self):
    while not self._window.should_close():
        performance_manager.begin_frame()

        with performance_manager.time_operation("Render"):
            self._render()

        performance_manager.end_frame()
バッチレンダリングの仕組み
バッチレンダリングの基本的な考え方は、複数のオブジェクトの頂点データを1つのバッファに結合し、1回のドローコールで描画することです。
実装の流れ
1. 各オブジェクトの頂点データを取得
   ↓
2. Transform行列を適用して頂点座標を変換 (CPU側)
   ↓
3. 全オブジェクトの頂点を1つの配列に結合
   ↓
4. 結合したデータでVBO/EBOを作成
   ↓
5. 1回のドローコールで全て描画
重要なポイント:
- Transform行列の適用をCPU側で行う(GPU側では単位行列を使用)
- インデックスのオフセット調整が必要
- 同じプリミティブタイプ(TRIANGLES, POINTS, LINES)でグループ化
BatchRenderer クラス
src/graphics/batch_renderer.py:
from dataclasses import dataclass
from typing import List, Optional
import numpy as np
import OpenGL.GL as gl

@dataclass
class RenderBatch:
    """1つのジオメトリの描画情報"""
    vertices: np.ndarray           # 頂点データ(Nx6: x,y,z,r,g,b)
    indices: Optional[np.ndarray]  # インデックスデータ
    transform: np.ndarray          # Model変換行列(4x4)
    vertex_offset: int = 0         # 結合後のオフセット
    vertex_count: int = 0          # 頂点数
    index_offset: int = 0          # インデックスオフセット
    index_count: int = 0           # インデックス数

class BatchRenderer:
    """バッチレンダリングクラス"""

    def __init__(self, primitive_type: PrimitiveType):
        self._primitive_type = primitive_type
        self._batches: List[RenderBatch] = []
        self._vao: int = 0
        self._vbo: int = 0
        self._ebo: int = 0
        self._is_dirty: bool = False
        self._use_indices: bool = False

    def add_geometry(self,
                     vertices: np.ndarray,
                     indices: Optional[np.ndarray],
                     transform: np.ndarray) -> None:
        """ジオメトリをバッチに追加"""
        batch = RenderBatch(
            vertices=vertices.copy(),
            indices=indices.copy() if indices is not None else None,
            transform=transform.copy(),
            vertex_count=len(vertices)
        )
        self._batches.append(batch)
        self._is_dirty = True

    def build(self) -> None:
        """バッチをビルド(頂点結合、バッファ作成)"""
        if not self._batches or not self._is_dirty:
            return

        # 1. Transform適用
        transformed_batches = []
        vertex_offset = 0

        for batch in self._batches:
            # 頂点にTransformを適用
            transformed_verts = self._apply_transform(
                batch.vertices,
                batch.transform
            )
            transformed_batches.append(transformed_verts)

            batch.vertex_offset = vertex_offset
            vertex_offset += batch.vertex_count

        # 2. 頂点データを結合
        combined_vertices = np.concatenate(transformed_batches, axis=0)

        # 3. インデックスデータを結合
        combined_indices = None
        if self._use_indices:
            combined_indices = self._combine_indices()

        # 4. OpenGLバッファを作成
        self._create_buffers(combined_vertices, combined_indices)

        self._is_dirty = False

    def flush(self) -> None:
        """バッチを描画"""
        if self._is_dirty:
            self.build()

        if self._vao == 0:
            return

        gl.glBindVertexArray(self._vao)

        if self._use_indices:
            gl.glDrawElements(
                self._primitive_type.value,
                self._total_indices,
                gl.GL_UNSIGNED_INT,
                None
            )
        else:
            gl.glDrawArrays(
                self._primitive_type.value,
                0,
                self._total_vertices
            )

        gl.glBindVertexArray(0)
Transform行列の適用
バッチレンダリングでは、各オブジェクトのTransform行列をCPU側で頂点に適用します。
_apply_transform メソッド
def _apply_transform(self,
                     vertices: np.ndarray,
                     transform: np.ndarray) -> np.ndarray:
    """頂点データにTransform行列を適用"""
    # 位置(xyz)と色(rgb)を分離
    positions = vertices[:, :3]  # (N, 3)
    colors = vertices[:, 3:6]    # (N, 3)

    # 同次座標に変換(w=1を追加)
    positions_homogeneous = np.hstack([
        positions,
        np.ones((len(positions), 1))
    ])  # (N, 4)

    # Transform行列を適用
    transformed_positions = (transform @ positions_homogeneous.T).T

    # 同次座標から3D座標に戻す(wで除算)
    transformed_positions = (
        transformed_positions[:, :3] /
        transformed_positions[:, 3:4]
    )

    # 位置と色を再結合
    result = np.hstack([transformed_positions, colors])

    return result.astype(np.float32)
ポイント:
- 位置座標のみを変換(色は変換しない)
- 同次座標(x, y, z, w)で計算
- 最後にwで除算して3D座標に戻す
インデックスの結合
複数のジオメトリのインデックスを結合する際は、頂点オフセットを考慮する必要があります。
_combine_indices メソッド
def _combine_indices(self) -> Optional[np.ndarray]:
    """インデックスを結合(オフセット調整付き)"""
    combined = []

    for batch in self._batches:
        if batch.indices is not None:
            # 頂点オフセットを加算
            adjusted_indices = batch.indices + batch.vertex_offset
            combined.append(adjusted_indices)

    if combined:
        return np.concatenate(combined, axis=0).astype(np.uint32)

    return None
例:
- オブジェクト1: 頂点0-3、インデックス[0,1,2, 2,3,0]
- オブジェクト2: 頂点4-7、インデックス[0,1,2, 2,3,0] → [4,5,6, 6,7,4]に調整
GeometryBase拡張: get_vertex_data()
各ジオメトリクラスに、バッチレンダリング用の頂点データ取得メソッドを追加します。
GeometryBaseの抽象メソッド
src/graphics/geometry.py:
from abc import ABC, abstractmethod

class GeometryBase(ABC):
    """ジオメトリの基底クラス"""

    @abstractmethod
    def get_vertex_data(self) -> Tuple[np.ndarray, Optional[np.ndarray]]:
        """
        バッチレンダリング用の頂点データを取得

        Returns:
            (vertices, indices): 頂点データとインデックスデータ
            vertices: Nx6 array (x,y,z,r,g,b)
            indices: インデックス配列(Optional)
        """
        pass
実装例: RectangleGeometry
class RectangleGeometry(GeometryBase):
    """矩形ジオメトリクラス"""

    def get_vertex_data(self) -> Tuple[np.ndarray, Optional[np.ndarray]]:
        """バッチレンダリング用の頂点データを取得"""
        w = self._width / 2.0
        h = self._height / 2.0
        r, g, b = self._color

        # 4頂点
        vertices = np.array([
            -w, -h, 0.0,  r, g, b,  # 左下
             w, -h, 0.0,  r, g, b,  # 右下
             w,  h, 0.0,  r, g, b,  # 右上
            -w,  h, 0.0,  r, g, b,  # 左上
        ], dtype=np.float32).reshape(4, 6)

        # 6インデックス(2三角形)
        indices = np.array([
            0, 1, 2,
            2, 3, 0,
        ], dtype=np.uint32)

        return vertices, indices
App統合: バッチレンダリングの切り替え
Appクラスで、従来の描画方式とバッチレンダリングを切り替えられるようにします。
バッチレンダリング用の描画メソッド
src/core/app.py:
def _draw_geometries(self) -> None:
    """ジオメトリを描画"""
    if self._use_batch_rendering and self._geometry_mode == 3:
        self._draw_with_batching()  # バッチレンダリング
    else:
        self._draw_without_batching()  # 従来の方法

def _draw_with_batching(self) -> None:
    """バッチレンダリングで描画"""
    # バッチレンダラーを初期化
    if self._batch_renderer_triangles is None:
        self._batch_renderer_triangles = BatchRenderer(
            PrimitiveType.TRIANGLES
        )

    self._batch_renderer_triangles.clear()

    # シェーダー設定
    self._shader.use()
    self._shader.set_mat4("view", camera.view_matrix)
    self._shader.set_mat4("projection", camera.projection_matrix)

    # 全オブジェクトをバッチに追加
    with performance_manager.time_operation("Build Batch"):
        for obj in self._all_mode_objects:
            # Model行列を計算
            self._transform.set_model_identity()
            self._transform.translate_model(*obj['pos'])
            self._transform.scale_model(obj['scale'], obj['scale'], obj['scale'])
            self._transform.rotate_model_x(self._rotation_x)
            self._transform.rotate_model_y(self._rotation_y)
            self._transform.rotate_model_z(self._rotation_z)
            model_matrix = self._transform.model.copy()

            # ジオメトリを取得
            geometry = self._get_geometry_for_type(obj['type'])

            if geometry:
                # 一時的に色を設定
                original_color = geometry._color
                geometry.set_color(*obj['color'])

                # 頂点データを取得
                vertices, indices = geometry.get_vertex_data()

                # 色を戻す
                geometry.set_color(*original_color)

                # バッチに追加
                self._batch_renderer_triangles.add_geometry(
                    vertices, indices, model_matrix
                )

    # バッチを描画(1回のドローコール)
    with performance_manager.time_operation("Draw Batch"):
        # Model行列は単位行列(頂点は既に変換済み)
        self._shader.set_mat4("model", np.eye(4, dtype=np.float32))
        self._batch_renderer_triangles.flush()

    # ドローコール数を記録
    performance_manager.set_draw_call_count(1)
従来の描画方法(比較用)
def _draw_without_batching(self) -> None:
    """従来の方法で描画"""
    draw_call_count = 0

    self._shader.use()
    self._shader.set_mat4("view", camera.view_matrix)
    self._shader.set_mat4("projection", camera.projection_matrix)

    # 各オブジェクトを個別に描画
    for obj in self._all_mode_objects:
        # Model行列を設定
        self._transform.set_model_identity()
        self._transform.translate_model(*obj['pos'])
        self._transform.scale_model(obj['scale'], obj['scale'], obj['scale'])
        self._transform.rotate_model_x(self._rotation_x)
        self._transform.rotate_model_y(self._rotation_y)
        self._transform.rotate_model_z(self._rotation_z)
        self._shader.set_mat4("model", self._transform.model)

        # 描画(各オブジェクトで1ドローコール)
        geometry = self._get_geometry_for_type(obj['type'])
        if geometry:
            original_color = geometry._color
            geometry.set_color(*obj['color'])
            geometry.draw()  # ← ドローコール発生
            geometry.set_color(*original_color)
            draw_call_count += 1

    performance_manager.set_draw_call_count(draw_call_count)
ImGui UI: バッチレンダリング切り替え
Settings ウィンドウにチェックボックスを追加して、バッチレンダリングのON/OFFを切り替えられるようにします。
def _draw_settings_window(self) -> None:
    """設定ウィンドウを描画"""
    imgui.begin("Settings")

    # バッチレンダリング設定
    changed, self._use_batch_rendering = imgui.checkbox(
        "Use Batch Rendering (All Mode)",
        self._use_batch_rendering
    )
    if imgui.is_item_hovered():
        imgui.set_tooltip(
            "Enable batch rendering to reduce draw calls\n"
            "(Only works in All mode)"
        )

    imgui.end()
Performance ウィンドウ: パフォーマンス表示
パフォーマンス計測結果を表示するウィンドウも追加します。
def _draw_performance_window(self) -> None:
    """パフォーマンスウィンドウを描画"""
    imgui.begin("Performance")

    stats = performance_manager.get_previous_frame_info()

    # FPS表示
    imgui.text(f"FPS: {stats.fps:.1f}")
    imgui.text(f"Frame Time: {stats.frame_time_ms:.2f}ms")
    imgui.text(f"Draw Calls: {performance_manager.get_draw_call_count()}")

    imgui.separator()

    # FPS統計
    if imgui.tree_node_ex("FPS Stats", imgui.TreeNodeFlags_.default_open):
        fps_stats = performance_manager.get_fps_stats()
        imgui.text(f"Average: {fps_stats['average']:.1f}")
        imgui.text(f"Max: {fps_stats['max']:.1f}")
        imgui.text(f"Min: {fps_stats['min']:.1f}")
        imgui.tree_pop()

    imgui.separator()

    # 処理時間の階層表示
    if imgui.tree_node_ex("Timing (Hierarchical)",
                          imgui.TreeNodeFlags_.default_open):
        self._draw_hierarchical_stats(stats.hierarchical_stats, 0)
        imgui.tree_pop()

    imgui.separator()

    # ログ出力ボタン
    if imgui.button("Print Stats to Log (Hierarchical)"):
        performance_manager.print_stats(hierarchical=True)

    if imgui.button("Print Stats to Log (Flat, Sorted)"):
        performance_manager.print_stats(hierarchical=False, sort_by_time=True)

    imgui.end()
パフォーマンス比較
実際の計測結果を詳しく見てみましょう。
測定環境と結果サマリー
9個のオブジェクト(矩形3個 + 立方体3個 + 球体3個)+ 点・線・三角形を描画した場合の測定結果:
| 項目 | 従来の方法 | バッチレンダリング | 改善率 |
|---|---|---|---|
| FPS | 50.7 | 75.8 | +50% |
| Frame Time | 19.73ms | 13.20ms | -33% |
| Draw Calls | 12回 | 4回 | -67% |
| 描画処理時間 | 15.24ms | 7.71ms | -49% |
バッチレンダリングにより、ドローコールで12回→4回に削減しました。その結果、FPSが50%向上し、フレーム時間が33%短縮し、描画処理時間が49%改善されました。
注意: これらの数値は特定の環境とオブジェクト数での測定結果です。バッチレンダリングの効果は、オブジェクト数が多いほど顕著になります。数十~数百個のオブジェクトを描画する場合、ドローコール削減による性能向上が明確に現れます。
バッチレンダリングOFF(従来の方法)

=== Performance Stats ===
FPS: 50.7
Frame Time: 19.73ms
Draw Calls: 12

Hierarchical Operation Timings:
  Render: 16.47ms (children: 15.58ms)
    Draw Geometries: 15.24ms (children: 15.14ms)
      Draw Points: 0.05ms
      Draw Lines: 0.01ms
      Draw Triangles: 0.01ms
      Draw All Objects: 15.07ms  ← オブジェクト描画
    Render GUI: 0.45ms
バッチレンダリングON

=== Performance Stats ===
FPS: 75.8
Frame Time: 13.20ms
Draw Calls: 4  ← 12回 → 4回に削減!

Hierarchical Operation Timings:
  Render: 8.50ms (children: 8.00ms)
    Draw Geometries: 7.71ms (children: 7.61ms)
      Build Batch: 7.01ms  ← CPU側での頂点変換とバッチ構築
      Draw Batch: 0.59ms   ← GPU描画(4回のドローコール)
    Render GUI: 0.40ms
詳細な性能比較
| 処理 | 従来の方法 | バッチレンダリング | 差異 |
|---|---|---|---|
| Draw Geometries全体 | 15.24ms | 7.71ms | -49% |
| Draw All Objects | 15.07ms | - | 個別描画 |
| Build Batch | - | 7.01ms | CPU処理 |
| Draw Batch | - | 0.59ms | GPU描画 |
| ドローコール数 | 12回 | 4回 | -67% |
考察:
- ドローコール数は12回→4回に削減(点1+線1+三角形1+矩形等1)
- CPU側のバッチ構築コスト(7.01ms)は存在するが、従来の個別描画(15.07ms)と比較して約半分に削減
- GPU描画時間も非常に短く(0.59ms)、ドライバオーバーヘッド削減の効果が明確
- 結果として、FPSが50%向上し、フレーム時間が33%短縮
- バッチレンダリングの効果が明確に確認できる結果
- より大規模なシーン(数十~数百オブジェクト)では、さらに顕著な効果が期待できる
ユニットテスト
バッチレンダリング機能の品質を保証するため、包括的なユニットテストを実装しました。
test_batch_renderer.py (20テスト)
class TestBatchRenderer:
    """BatchRendererクラスのテスト"""

    def test_add_geometry_basic(self):
        """ジオメトリの追加(基本)"""
        renderer = BatchRenderer(PrimitiveType.TRIANGLES)

        vertices = np.array([
            [0.0, 0.0, 0.0, 1.0, 0.0, 0.0],
            [1.0, 0.0, 0.0, 0.0, 1.0, 0.0],
            [0.0, 1.0, 0.0, 0.0, 0.0, 1.0],
        ], dtype=np.float32)

        indices = np.array([0, 1, 2], dtype=np.uint32)
        transform = np.eye(4, dtype=np.float32)

        renderer.add_geometry(vertices, indices, transform)

        assert len(renderer._batches) == 1
        assert renderer._is_dirty is True
        assert renderer.batch_count == 1

    def test_apply_transform_translation(self):
        """Transform適用(平行移動)"""
        renderer = BatchRenderer(PrimitiveType.TRIANGLES)

        vertices = np.array([
            [0.0, 0.0, 0.0, 1.0, 0.0, 0.0],
        ], dtype=np.float32)

        # 平行移動行列(x+1, y+2, z+3)
        transform = np.array([
            [1, 0, 0, 1],
            [0, 1, 0, 2],
            [0, 0, 1, 3],
            [0, 0, 0, 1],
        ], dtype=np.float32)

        result = renderer._apply_transform(vertices, transform)

        # 位置が変換される
        expected_pos = np.array([[1.0, 2.0, 3.0]])
        np.testing.assert_array_almost_equal(result[:, :3], expected_pos)

        # 色は変わらない
        np.testing.assert_array_almost_equal(result[:, 3:], vertices[:, 3:])

    def test_combine_indices_multiple_batches(self):
        """インデックス結合(複数バッチ)"""
        renderer = BatchRenderer(PrimitiveType.TRIANGLES)

        # バッチ1: 頂点0-2
        vertices1 = np.array([
            [0.0, 0.0, 0.0, 1.0, 0.0, 0.0],
            [1.0, 0.0, 0.0, 0.0, 1.0, 0.0],
            [0.0, 1.0, 0.0, 0.0, 0.0, 1.0],
        ], dtype=np.float32)
        indices1 = np.array([0, 1, 2], dtype=np.uint32)
        transform = np.eye(4, dtype=np.float32)

        renderer.add_geometry(vertices1, indices1, transform)
        renderer._batches[0].vertex_offset = 0

        # バッチ2: 頂点3-5(オフセット3)
        vertices2 = np.array([
            [2.0, 0.0, 0.0, 1.0, 0.0, 0.0],
            [3.0, 0.0, 0.0, 0.0, 1.0, 0.0],
            [2.0, 1.0, 0.0, 0.0, 0.0, 1.0],
        ], dtype=np.float32)
        indices2 = np.array([0, 1, 2], dtype=np.uint32)

        renderer.add_geometry(vertices2, indices2, transform)
        renderer._batches[1].vertex_offset = 3

        combined = renderer._combine_indices()

        # バッチ2のインデックスはオフセット3が加算される
        expected = np.array([0, 1, 2, 3, 4, 5], dtype=np.uint32)
        np.testing.assert_array_equal(combined, expected)
test_geometry.py拡張 (35テスト追加)
全てのジオメトリクラスのget_vertex_data()メソッドをテストしました:
class TestRectangleGeometryVertexData:
    """RectangleGeometryのget_vertex_data()テスト"""

    def test_get_vertex_data(self) -> None:
        """矩形の頂点データ取得"""
        mock_manager = MockBufferManager()
        geom = RectangleGeometry(width=2.0, height=1.0,
                                 buffer_manager=mock_manager)

        vertices, indices = geom.get_vertex_data()

        assert vertices.shape == (4, 6)  # 4頂点
        assert indices is not None
        assert indices.shape == (6,)  # 2三角形 = 6インデックス
        np.testing.assert_array_equal(indices, [0, 1, 2, 2, 3, 0])
テスト結果:
- ✅ test_batch_renderer.py: 20テスト全て成功
- ✅ test_geometry.py: 35テスト追加(全て成功)
- ✅ 合計55テスト
バッチレンダリングの制約と最適化のポイント
制約事項
プリミティブタイプの統一
- 同じプリミティブ(TRIANGLES, POINTS, LINES)のみバッチ化可能
- 異なるプリミティブは別々のBatchRendererが必要
動的オブジェクトのコスト
- 毎フレーム位置が変わるオブジェクトは、毎回
build()が必要 - 静的オブジェクトの方がバッチレンダリングに適している
- 毎フレーム位置が変わるオブジェクトは、毎回
CPU処理の増加
- Transform適用がCPU側で行われる
- オブジェクト数が非常に多い場合はCPUボトルネックになる可能性
最適化のポイント
静的バッチング vs 動的バッチング
- 静的: 位置が固定のオブジェクト → 1回だけbuild()
- 動的: 毎フレーム動くオブジェクト → 毎フレームbuild()
- 今回は動的バッチングを実装
インスタンシング(次のステップ)
- 同じジオメトリを複数描画する場合はインスタンシングが有効
- GPUで各インスタンスのTransformを処理
- より多くのオブジェクトを高速に描画可能
カリング(描画範囲外の除外)
- カメラに映らないオブジェクトは描画しない
- フラスタムカリングで更に高速化
まとめ
今回は、バッチレンダリングを実装して描画パフォーマンスを大幅に向上させました。
実装した内容
パフォーマンス計測基盤
- PerformanceManagerクラス
- 階層的な処理時間計測
- FPS統計、ドローコール数の記録
BatchRendererクラス
- 複数ジオメトリの頂点結合
- CPU側でのTransform適用
- インデックスのオフセット調整
- 1回のドローコールで描画
GeometryBase拡張
- get_vertex_data()メソッド追加
- 全ジオメトリクラスで実装
App統合
- バッチレンダリングの切り替え機能
- Performance ウィンドウでの可視化
達成した結果
- FPS: 50.7 → 75.8 (+50%)
- Frame Time: 19.73ms → 13.20ms (-33%)
- Draw Calls: 12回 → 4回 (-67%)
- Draw Geometries: 15.24ms → 7.71ms (-49%)
- Build Batch (CPU): 7.01ms
- Draw Batch (GPU): 0.59ms
重要な知見:
- ドローコール削減によるパフォーマンスの大幅向上を達成
- 個別描画時のドライバオーバーヘッド(15.24ms)と比較して、バッチ構築コスト(7.01ms)+ 描画(0.59ms)= 7.60msと約半分に高速化
- FPSが50%向上し、フレーム時間が33%短縮
- より大規模なシーン(数十~数百オブジェクト)では、さらに顕著な効果が期待できる
学んだこと
ドローコールの削減が効果的
- CPU-GPU通信のオーバーヘッドを削減することで描画時間が半減
- 今回の計測では15.24ms → 7.71ms(-49%)の改善を達成
- 少数の大きな描画命令が効率的
CPU vs GPU のバランス
- Transform適用をCPU側に移すことで、GPU側の負荷を大幅削減
- バッチ構築コスト(7.01ms)よりもドライバオーバーヘッド削減効果(15.24ms → 0.59ms)が大きい
- トータルで大幅な高速化を実現
計測の重要性
- PerformanceManagerで定量的に効果を確認
- 最適化の指針を得られる
次回は、インスタンシング(Instancing)を実装して、同じジオメトリの大量描画を更に高速化します。お楽しみに!
前回: 第9回「立方体と球体を描く - EBOで頂点を再利用」
この記事のコード: GitHub - PythonOpenGL Phase 7a
【GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング】 - 第9回「立方体と球体を描く - EBOで頂点を再利用」
GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
第9回「立方体と球体を描く - EBOで頂点を再利用」
- GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
はじめに
前回は、点・線・三角形という基本形状(プリミティブ)の描画を学び、VBO/VAOの概念を理解しました。
今回は、EBO(Element Buffer Object / Index Buffer)を使って、より複雑な形状を効率的に描画する方法を学びます。具体的には、矩形(Rectangle)、立方体(Cube)、球体(Sphere)の描画を実装します。
また、OpenGL操作を抽象化するBufferManagerパターンを導入し、テスト容易性を向上させます。
BufferManagerパターンの実装
複雑な形状を実装する前に、まずOpenGL操作を抽象化する設計パターンを導入します。これにより、以下のメリットが得られます:
BufferManager Protocol
src/graphics/geometry.py:
class BufferManager(Protocol):
    """OpenGL操作の抽象化インターフェース"""

    def create_buffers(
        self,
        vertices: np.ndarray,
        primitive_type: PrimitiveType
    ) -> tuple[int, int]:
        """VBO/VAOを作成"""
        ...

    def create_indexed_buffers(
        self,
        vertices: np.ndarray,
        indices: np.ndarray,
        primitive_type: PrimitiveType
    ) -> tuple[int, int, int]:
        """VBO/VAO/EBOを作成"""
        ...

    def draw_arrays(self, vao: int, vertex_count: int, primitive_type: PrimitiveType) -> None:
        """通常描画(VBOのみ)"""
        ...

    def draw_elements(self, vao: int, index_count: int, primitive_type: PrimitiveType) -> None:
        """インデックス描画(VBO + EBO)"""
        ...
実装クラスOpenGLBufferManagerが実際のOpenGL関数を呼び出します。
BufferManagerのテスト容易性
このパターンにより、MockBufferManagerを使ってOpenGLコンテキスト不要なユニットテストを実現できます:
# tests/test_geometry.py
class MockBufferManager:
    """テスト用のモックBufferManager"""

    def create_indexed_buffers(self, vertices, indices, primitive_type):
        # 実際のOpenGL呼び出しなし、ダミーID返却
        return (1, 2, 3)  # VAO, VBO, EBO

    def draw_elements(self, vao, index_count, primitive_type):
        # 描画記録のみ
        self.draw_calls.append(("elements", vao, index_count))

# テスト例
def test_rectangle_init():
    mock = MockBufferManager()
    rect = RectangleGeometry(width=2.0, height=1.5, buffer_manager=mock)

    assert rect.vertex_count == 4
    assert rect.index_count == 6
    assert mock.created_buffers_count == 1
全22テストがOpenGL初期化なしで実行可能です:
pytest tests/test_geometry.py -v
# ====================== 22 passed in 0.64s ======================
EBOとは何か?
頂点の重複問題
前回の三角形描画では、頂点データを直接VBOに格納していました。しかし、複雑な形状を描く場合、同じ頂点を複数回使い回す必要があります。
例えば、矩形(四角形)を三角形で描く場合:
三角形2つで矩形を構成
┌───────┐
│ \    │
│   \  │  三角形1: (0, 1, 2)
│     \│  三角形2: (0, 2, 3)
└───────┘

頂点データ(重複なし):
0: (-0.5, -0.5)  左下
1: ( 0.5, -0.5)  右下
2: ( 0.5,  0.5)  右上
3: (-0.5,  0.5)  左上
VBOだけで描画する場合、6頂点(3頂点×2三角形)を送る必要があり、頂点0と頂点2が重複します。
EBOによる解決
EBO(Element Buffer Object)は、頂点のインデックス(番号)を格納するバッファです。頂点データは一度だけVBOに格納し、EBOで「どの順番で頂点を使うか」を指定します。
VBO: 頂点データ4つ
┌────┬────┬────┬────┐
│ 0  │ 1  │ 2  │ 3  │
└────┴────┴────┴────┘

EBO: インデックスデータ6つ
┌────┬────┬────┬────┬────┬────┐
│ 0  │ 1  │ 2  │ 0  │ 2  │ 3  │
└────┴────┴────┴────┴────┴────┘
 └─────────┘  └─────────┘
  三角形1       三角形2
これにより、頂点データの重複を削減し、メモリ効率と転送効率が向上します。
矩形(Rectangle)の実装
頂点データとインデックス
4頂点で矩形を構成し、2つの三角形で描画します:
class RectangleGeometry(GeometryBase):
    def _update_buffers(self) -> None:
        w = self._width / 2.0
        h = self._height / 2.0
        r, g, b = self._color

        # 頂点データ(4頂点)
        vertices = np.array([
            # 位置           色
            -w, -h, 0.0,  r, g, b,  # 左下
             w, -h, 0.0,  r, g, b,  # 右下
             w,  h, 0.0,  r, g, b,  # 右上
            -w,  h, 0.0,  r, g, b,  # 左上
        ], dtype=np.float32)

        # インデックスデータ(2三角形 = 6インデックス)
        indices = np.array([
            0, 1, 2,  # 三角形1(左下・右下・右上)
            0, 2, 3,  # 三角形2(左下・右上・左上)
        ], dtype=np.uint32)

        # EBOを使用してバッファ作成
        self._vao, self._vbo, self._ebo = self._buffer_manager.create_indexed_buffers(
            vertices, indices, PrimitiveType.TRIANGLES
        )
サイズ・色の変更
def set_size(self, width: float, height: float) -> None:
    """サイズを変更"""
    self._width = width
    self._height = height
    self._update_buffers()

def set_color(self, r: float, g: float, b: float) -> None:
    """色を変更"""
    self._color = (r, g, b)
    self._update_buffers()
立方体(Cube)の実装
立方体の構造
立方体は8頂点、6面(各面は2三角形)で構成されます:
立方体の頂点番号
      7-------6
     /|      /|
    4-------5 |
    | |     | |
    | 3-----|-2
    |/      |/
    0-------1

各面のインデックス(反時計回り):
前面: 0, 1, 5, 0, 5, 4
右面: 1, 2, 6, 1, 6, 5
背面: 2, 3, 7, 2, 7, 6
左面: 3, 0, 4, 3, 4, 7
上面: 4, 5, 6, 4, 6, 7
底面: 3, 2, 1, 3, 1, 0
合計:8頂点、36インデックス(12三角形)
頂点データとインデックス
class CubeGeometry(GeometryBase):
    def _update_buffers(self) -> None:
        s = self._size / 2.0
        r, g, b = self._color

        # 8頂点(各頂点に色を付与)
        vertices = np.array([
            # 位置              色
            -s, -s, -s,  r, g, b,  # 0: 左下前
             s, -s, -s,  r, g, b,  # 1: 右下前
             s,  s, -s,  r, g, b,  # 2: 右上前
            -s,  s, -s,  r, g, b,  # 3: 左上前
            -s, -s,  s,  r, g, b,  # 4: 左下奥
             s, -s,  s,  r, g, b,  # 5: 右下奥
             s,  s,  s,  r, g, b,  # 6: 右上奥
            -s,  s,  s,  r, g, b,  # 7: 左上奥
        ], dtype=np.float32)

        # 6面×2三角形 = 36インデックス
        indices = np.array([
            0, 1, 5, 0, 5, 4,  # 前面
            1, 2, 6, 1, 6, 5,  # 右面
            2, 3, 7, 2, 7, 6,  # 背面
            3, 0, 4, 3, 4, 7,  # 左面
            4, 5, 6, 4, 6, 7,  # 上面
            3, 2, 1, 3, 1, 0,  # 底面
        ], dtype=np.uint32)

        self._vao, self._vbo, self._ebo = self._buffer_manager.create_indexed_buffers(
            vertices, indices, PrimitiveType.TRIANGLES
        )
球体(Sphere)の実装
球面の数式
球体は経度(longitude)と緯度(latitude)で分割して生成します。
球面上の点 (x, y, z) は、半径 r、経度 θ(シータ)、緯度 φ(ファイ)から計算します:
x = r × cos(φ) × cos(θ)
y = r × sin(φ)
z = r × cos(φ) × sin(θ)
頂点生成アルゴリズム
def _generate_vertices(self) -> tuple[np.ndarray, np.ndarray]:
    vertices = []
    indices = []

    # 各リング(緯度方向)
    for i in range(self._rings + 1):
        phi = np.pi / 2 - i * np.pi / self._rings  # π/2 → -π/2

        # 各セグメント(経度方向)
        for j in range(self._segments + 1):
            theta = j * 2 * np.pi / self._segments  # 0 → 2π

            x = self._radius * np.cos(phi) * np.cos(theta)
            y = self._radius * np.sin(phi)
            z = self._radius * np.cos(phi) * np.sin(theta)

            vertices.extend([x, y, z, *self._color])

    # インデックス生成(各四角形を2三角形に分割)
    for i in range(self._rings):
        for j in range(self._segments):
            first = i * (self._segments + 1) + j
            second = first + self._segments + 1

            # 三角形1
            indices.extend([first, second, first + 1])
            # 三角形2
            indices.extend([second, second + 1, first + 1])

    return np.array(vertices, dtype=np.float32), np.array(indices, dtype=np.uint32)
頂点数・インデックス数
- 頂点数: (rings + 1) × (segments + 1)
- インデックス数: rings × segments × 6
例:segments=16, rings=16の場合:
- 頂点数: 17 × 17 = 289
- インデックス数: 16 × 16 × 6 = 1536
アプリケーションへの統合
形状の初期化
src/core/app.py:
def _setup_geometries(self) -> None:
    """ジオメトリをセットアップする"""
    # === 矩形ジオメトリ ===
    self._rectangle_geometry = RectangleGeometry(
        width=1.0,
        height=1.0,
        r=0.5, g=0.5, b=1.0,
    )

    # === 立方体ジオメトリ ===
    self._cube_geometry = CubeGeometry(
        size=1.0,
        r=0.5, g=0.5, b=1.0,
    )

    # === 球体ジオメトリ ===
    self._sphere_geometry = SphereGeometry(
        radius=1.0,
        segments=16,
        rings=16,
        r=0.5, g=0.5, b=1.0,
    )
imgui UI
形状選択、サイズ調整、色変更を可能にします:
def _draw_geometry_window(self) -> None:
    imgui.begin("Geometry")

    # 表示モードの選択
    mode_names = ["Points", "Lines", "Triangles", "All", "Rectangle", "Cube", "Sphere"]
    changed, self._geometry_mode = imgui.combo("Display Mode", self._geometry_mode, mode_names)

    # === 矩形の設定 ===
    if imgui.collapsing_header("Rectangle", imgui.TreeNodeFlags_.default_open.value):
        changed_w, self._rectangle_width = imgui.slider_float("Width", self._rectangle_width, 0.1, 3.0)
        changed_h, self._rectangle_height = imgui.slider_float("Height", self._rectangle_height, 0.1, 3.0)
        if changed_w or changed_h:
            self._rectangle_geometry.set_size(self._rectangle_width, self._rectangle_height)

    # === 立方体の設定 ===
    if imgui.collapsing_header("Cube"):
        changed_s, self._cube_size = imgui.slider_float("Size", self._cube_size, 0.1, 3.0)
        if changed_s:
            self._cube_geometry.set_size(self._cube_size)

    # === 球体の設定 ===
    if imgui.collapsing_header("Sphere"):
        changed_r, self._sphere_radius = imgui.slider_float("Radius", self._sphere_radius, 0.1, 3.0)
        changed_seg, self._sphere_segments = imgui.slider_int("Segments", self._sphere_segments, 4, 64)
        changed_ring, self._sphere_rings = imgui.slider_int("Rings", self._sphere_rings, 2, 64)

        if changed_r or changed_seg or changed_ring:
            # 球体を再生成
            self._sphere_geometry.cleanup()
            self._sphere_geometry = SphereGeometry(
                radius=self._sphere_radius,
                segments=self._sphere_segments,
                rings=self._sphere_rings,
                r=self._shape_color[0],
                g=self._shape_color[1],
                b=self._shape_color[2],
            )

    imgui.end()
描画処理
def _draw_geometries(self) -> None:
    # ... Model/View/Projection行列設定 ...

    if self._geometry_mode == 4:  # Rectangle
        if self._rectangle_geometry:
            self._rectangle_geometry.draw()

    if self._geometry_mode == 5:  # Cube
        if self._cube_geometry:
            self._cube_geometry.draw()

    if self._geometry_mode == 6:  # Sphere
        if self._sphere_geometry:
            self._sphere_geometry.draw()
実行結果
アプリケーションを実行すると:
source .venv/bin/activate && python -m src.main
- Geometryウィンドウで
Display Modeを選択 Rectangle、Cube、Sphereを選択すると各形状が表示される- パラメータを調整して、サイズ・色・分割数を変更できる
- Transformウィンドウで回転させて立体感を確認
- Wireframe Modeで形状の構造を確認
- Random Colorボタンで各頂点にランダムな色を設定し、グラデーション効果を楽しめる
Allモード - 複数オブジェクトの描画

Point/Line/Triangle + Rectangle/Cube/Sphere(各3個)を同時に表示。ランダムな位置・スケール・色で配置される。
Wireframeモード - 構造の可視化

立方体や球体の三角形分割構造が明確に見える。
Rectangle - デフォルト色表示

4頂点、6インデックス(2三角形)で構成される矩形。
Cube - ランダム色グラデーション

8頂点それぞれに異なる色を設定。各面がカラフルなグラデーションになる。
Sphere - ランダム色グラデーション

全頂点に異なる色を設定。経度・緯度分割による美しいグラデーション球体。
まとめ
今回は、EBO(インデックスバッファ)を使って複雑な形状を効率的に描画する方法を学びました。
学んだこと:
- BufferManagerパターンによるテスト容易性
- EBOによる頂点の再利用(メモリ効率向上)
- 矩形の実装(4頂点、6インデックス)
- 立方体の実装(8頂点、36インデックス)
- 球体の生成アルゴリズム(経度・緯度分割)
次回予告: 次回は、「バッチ描画による高速化」を実装します。複数オブジェクトの描画を効率化し、ドローコールのオーバーヘッドを削減します。
前回: 第8回「点・線・三角形を描く」
【GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング】 - 第8回「点・線・三角形を描く - VBO/VAOの基礎」
GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
第8回「点・線・三角形を描く - VBO/VAOの基礎」
はじめに
前回までで、座標変換とカメラ操作を実装し、3D空間を自由に見回せるようになりました。
今回は、基本形状(プリミティブ)の描画を学びます。OpenGLでは、点・線・三角形が最も基本的な描画単位です。これらを効率的に管理するため、VBO(Vertex Buffer Object)とVAO(Vertex Array Object)の概念を理解し、再利用可能なジオメトリクラスを実装します。
VBO/VAOとは
これまで三角形を描画するとき、頂点データをシェーダーに渡していました。実は、その裏側ではVBOとVAOが働いています。
VBO(Vertex Buffer Object)
VBOは、頂点データをGPUメモリに格納するバッファです。CPUからGPUへのデータ転送は遅いため、頂点データを一度VBOに格納しておくことで、描画のたびにデータを転送する必要がなくなります。
CPU側(遅い)          GPU側(速い)
┌────────────┐       ┌────────────┐
│ 頂点データ   │ ──→   │    VBO     │ ──→ シェーダー
└────────────┘ 転送  └────────────┘
VAO(Vertex Array Object)
VAOは、頂点属性の設定を記録するオブジェクトです。「このVBOのこの部分が位置データで、あの部分が色データ」という設定を保存しておくことで、描画時に毎回設定し直す必要がなくなります。
VAOが記憶する情報:
┌─────────────────────────────────────────────┐
│ ・どのVBOを使うか                             │
│ ・属性0(位置): offset=0, 3要素, float型      │
│ ・属性1(色): offset=12, 3要素, float型       │
│ ・stride(1頂点のバイト数): 24バイト           │
└─────────────────────────────────────────────┘
OpenGLのプリミティブタイプ
OpenGLがサポートする基本的な描画モードです:
| モード | 説明 | 用途 |
|---|---|---|
GL_POINTS |
各頂点を点として描画 | パーティクル、デバッグ表示 |
GL_LINES |
2頂点ごとに独立した線分 | 座標軸、ワイヤーフレーム |
GL_LINE_STRIP |
連続した折れ線 | パス、軌跡 |
GL_LINE_LOOP |
折れ線の始点と終点を結ぶ | 閉じた輪郭線 |
GL_TRIANGLES |
3頂点ごとに独立した三角形 | 塗りつぶし面 |
GL_TRIANGLE_STRIP |
連続した三角形(頂点を共有) | メッシュの効率的描画 |
GL_TRIANGLE_FAN |
中心点から扇形に広がる三角形 | 円、扇形 |
今回はGL_POINTS、GL_LINES、GL_TRIANGLESを使います。
ジオメトリクラスの設計
VBO/VAOの管理を抽象化し、点・線・三角形それぞれに特化したクラスを作成します。
GeometryBase(抽象基底クラス)
├── PointGeometry     # GL_POINTS
├── LineGeometry      # GL_LINES
└── TriangleGeometry  # GL_TRIANGLES
ジオメトリ基底クラス
src/graphics/geometry.py:
"""
ジオメトリモジュール

基本形状(点・線・三角形)の描画を提供
"""
from abc import ABC, abstractmethod
from enum import Enum
from typing import List, Tuple, Optional

import numpy as np
import OpenGL.GL as gl

from src.utils.logger import logger


class PrimitiveType(Enum):
    """描画プリミティブタイプ"""
    POINTS = gl.GL_POINTS
    LINES = gl.GL_LINES
    LINE_STRIP = gl.GL_LINE_STRIP
    LINE_LOOP = gl.GL_LINE_LOOP
    TRIANGLES = gl.GL_TRIANGLES
    TRIANGLE_STRIP = gl.GL_TRIANGLE_STRIP
    TRIANGLE_FAN = gl.GL_TRIANGLE_FAN


class GeometryBase(ABC):
    """
    ジオメトリの基底クラス

    VBO/VAOを管理し、描画機能を提供する抽象クラス
    """

    def __init__(self) -> None:
        """ジオメトリを初期化する"""
        self._vao: int = 0
        self._vbo: int = 0
        self._vertex_count: int = 0
        self._is_initialized: bool = False

    @property
    @abstractmethod
    def primitive_type(self) -> PrimitiveType:
        """描画プリミティブタイプを取得"""
        pass

    @property
    def vertex_count(self) -> int:
        """頂点数を取得"""
        return self._vertex_count

    @property
    def is_initialized(self) -> bool:
        """初期化済みかどうか"""
        return self._is_initialized
VBO/VAOの作成
頂点データ(位置XYZ + 色RGB)をGPUに転送し、属性を設定します:
def _create_buffers(self, vertices: np.ndarray) -> None:
    """
    VBO/VAOを作成する

    Args:
        vertices: 頂点データ(位置x,y,z + 色r,g,b)
    """
    if self._is_initialized:
        self._delete_buffers()

    # VAO(頂点配列オブジェクト)の作成
    self._vao = gl.glGenVertexArrays(1)
    gl.glBindVertexArray(self._vao)

    # VBO(頂点バッファオブジェクト)の作成
    self._vbo = gl.glGenBuffers(1)
    gl.glBindBuffer(gl.GL_ARRAY_BUFFER, self._vbo)
    gl.glBufferData(gl.GL_ARRAY_BUFFER, vertices.nbytes, vertices, gl.GL_STATIC_DRAW)

    # 頂点属性の設定
    stride = 6 * vertices.itemsize  # 1頂点あたり6つのfloat(位置3 + 色3)

    # 属性0: 位置(location = 0)
    gl.glVertexAttribPointer(0, 3, gl.GL_FLOAT, gl.GL_FALSE, stride, None)
    gl.glEnableVertexAttribArray(0)

    # 属性1: 色(location = 1)
    import ctypes
    offset = 3 * vertices.itemsize
    gl.glVertexAttribPointer(1, 3, gl.GL_FLOAT, gl.GL_FALSE, stride, ctypes.c_void_p(offset))
    gl.glEnableVertexAttribArray(1)

    # バインド解除
    gl.glBindBuffer(gl.GL_ARRAY_BUFFER, 0)
    gl.glBindVertexArray(0)

    self._vertex_count = len(vertices) // 6
    self._is_initialized = True
ポイント:
glGenVertexArrays/glGenBuffers: VAO/VBOを生成glBindVertexArray/glBindBuffer: 操作対象を選択glBufferData: 頂点データをGPUに転送glVertexAttribPointer: 頂点属性のレイアウトを設定glEnableVertexAttribArray: 属性を有効化
描画処理
VAOをバインドしてglDrawArraysを呼ぶだけでシンプルに描画できます:
def draw(self) -> None:
    """ジオメトリを描画する"""
    if not self._is_initialized:
        return

    gl.glBindVertexArray(self._vao)
    gl.glDrawArrays(self.primitive_type.value, 0, self._vertex_count)
    gl.glBindVertexArray(0)
VAOのおかげで、描画時に頂点属性を再設定する必要がありません。
点ジオメトリ(PointGeometry)
点の描画に特化したクラスです。点のサイズをglPointSizeで設定できます。
class PointGeometry(GeometryBase):
    """
    点ジオメトリクラス

    GL_POINTSを使用して点を描画
    """

    def __init__(self, points: Optional[List[Tuple[float, ...]]] = None) -> None:
        super().__init__()
        self._points: List[Tuple[float, ...]] = []
        self._point_size: float = 5.0

        if points:
            self._points = list(points)
            self._update_buffers()

    @property
    def primitive_type(self) -> PrimitiveType:
        return PrimitiveType.POINTS

    def set_point_size(self, size: float) -> None:
        """点のサイズを設定"""
        self._point_size = max(1.0, size)

    def add_point(self, x: float, y: float, z: float,
                  r: float = 1.0, g: float = 1.0, b: float = 1.0) -> None:
        """点を追加する"""
        self._points.append((x, y, z, r, g, b))
        self._update_buffers()

    def draw(self) -> None:
        """点を描画する"""
        if not self._is_initialized:
            return

        # 点のサイズを設定
        gl.glPointSize(self._point_size)
        super().draw()
線ジオメトリ(LineGeometry)
線分の描画に特化したクラスです。単色の線とグラデーション線の両方に対応しています。
class LineGeometry(GeometryBase):
    """
    線ジオメトリクラス

    GL_LINESを使用して線分を描画
    """

    def add_line(self, x1: float, y1: float, z1: float,
                 x2: float, y2: float, z2: float,
                 r: float = 1.0, g: float = 1.0, b: float = 1.0) -> None:
        """線分を追加する(単色)"""
        self._lines.append((
            (x1, y1, z1, r, g, b),
            (x2, y2, z2, r, g, b)
        ))
        self._update_buffers()

    def add_line_colored(self,
                         x1: float, y1: float, z1: float, r1: float, g1: float, b1: float,
                         x2: float, y2: float, z2: float, r2: float, g2: float, b2: float) -> None:
        """線分を追加する(グラデーション)"""
        self._lines.append((
            (x1, y1, z1, r1, g1, b1),
            (x2, y2, z2, r2, g2, b2)
        ))
        self._update_buffers()
Note(macOSの制限): macOSのOpenGL Core Profileでは、glLineWidth()に1.0より大きい値を設定しても無視されます(またはエラーになります)。これはOpenGL 3.2以降のCore Profileの仕様で、太い線の描画はサポートされていません。そのため、本サンプルではLine Widthのスライダーは省略しています。太い線が必要な場合は、ジオメトリシェーダーで線を矩形に拡張する方法がありますが、それは将来のフェーズで紹介します。
三角形ジオメトリ(TriangleGeometry)
三角形の描画に特化したクラスです。塗りつぶされた面を描画できます。
class TriangleGeometry(GeometryBase):
    """
    三角形ジオメトリクラス

    GL_TRIANGLESを使用して三角形を描画
    """

    def add_triangle(self, x1: float, y1: float, z1: float,
                     x2: float, y2: float, z2: float,
                     x3: float, y3: float, z3: float,
                     r: float = 1.0, g: float = 1.0, b: float = 1.0) -> None:
        """三角形を追加する(単色)"""
        self._triangles.append((
            (x1, y1, z1, r, g, b),
            (x2, y2, z2, r, g, b),
            (x3, y3, z3, r, g, b)
        ))
        self._update_buffers()

    def add_triangle_colored(self,
                             x1: float, y1: float, z1: float, r1: float, g1: float, b1: float,
                             x2: float, y2: float, z2: float, r2: float, g2: float, b2: float,
                             x3: float, y3: float, z3: float, r3: float, g3: float, b3: float) -> None:
        """三角形を追加する(頂点ごとに色指定)"""
        self._triangles.append((
            (x1, y1, z1, r1, g1, b1),
            (x2, y2, z2, r2, g2, b2),
            (x3, y3, z3, r3, g3, b3)
        ))
        self._update_buffers()
深度テストの有効化
3D空間で複数のオブジェクトを描画する場合、手前のものが奥のものを隠す必要があります。これを実現するのが深度テスト(Depth Test)です。
def _render(self) -> None:
    """描画処理"""
    # 背景色の適用
    gl.glClearColor(*self._clear_color)

    # 深度テストを有効化(3D描画用)
    gl.glEnable(gl.GL_DEPTH_TEST)

    # 画面のクリア(カラーバッファと深度バッファの両方)
    gl.glClear(int(gl.GL_COLOR_BUFFER_BIT) | int(gl.GL_DEPTH_BUFFER_BIT))

    # ジオメトリの描画
    self._draw_geometries()

    # imguiのレンダリング...
ポイント:
glEnable(GL_DEPTH_TEST): 深度テストを有効化glClear(GL_DEPTH_BUFFER_BIT): 深度バッファもクリアする必要がある
深度テストの制限
深度テストは「各ピクセルのZ値を比較して、手前にあるものだけを描画する」仕組みです。ただし、以下の場合は期待通りに動作しないことがあります:
- 同じ深度の面が重なる場合(Z-fighting): ほぼ同じZ値の面同士がちらつく
- 半透明オブジェクト: 深度値は書き込まれるが、奥のオブジェクトは見えなくなる
- 描画順序: 同じ深度の三角形は描画順で決まる
下の画像のように、同じZ値(z=0)に多数の三角形を重ねると、描画順序によって表示が崩れることがあります。これは深度テストの正常な動作であり、バグではありません。

より高度な描画(半透明や重なりの正確な処理)には、描画順序の管理やブレンディングの設定が必要になります。これらは後のフェーズで扱います。
Appクラスへの統合
ジオメトリクラスをAppクラスに組み込み、imguiで操作できるようにします。
def _setup_geometries(self) -> None:
    """ジオメトリをセットアップする"""
    # === 点ジオメトリ ===
    self._point_geometry = PointGeometry()
    self._point_geometry.set_point_size(8.0)
    # サンプルの点を追加
    self._point_geometry.add_point(-0.8, 0.8, 0.0, 1.0, 0.0, 0.0)   # 赤
    self._point_geometry.add_point(0.0, 0.8, 0.0, 0.0, 1.0, 0.0)    # 緑
    self._point_geometry.add_point(0.8, 0.8, 0.0, 0.0, 0.0, 1.0)    # 青

    # === 線ジオメトリ ===
    self._line_geometry = LineGeometry()
    self._line_geometry.set_line_width(2.0)
    # 座標軸
    self._line_geometry.add_line(-1.0, 0.0, 0.0, 1.0, 0.0, 0.0, 1.0, 0.0, 0.0)  # X軸(赤)
    self._line_geometry.add_line(0.0, -1.0, 0.0, 0.0, 1.0, 0.0, 0.0, 1.0, 0.0)  # Y軸(緑)
    self._line_geometry.add_line(0.0, 0.0, -1.0, 0.0, 0.0, 1.0, 0.0, 0.0, 1.0)  # Z軸(青)

    # === 三角形ジオメトリ ===
    self._triangle_geometry = TriangleGeometry()
    # 虹色の三角形
    self._triangle_geometry.add_triangle_colored(
        -0.5, -0.5, 0.0, 1.0, 0.0, 0.0,  # 左下: 赤
        0.5, -0.5, 0.0, 0.0, 1.0, 0.0,   # 右下: 緑
        0.0, 0.5, 0.0, 0.0, 0.0, 1.0     # 上: 青
    )
imguiでインタラクティブに操作
形状の追加・クリア、表示モードの切り替えをimguiで行えるようにしました。
def _draw_geometry_window(self) -> None:
    """形状ウィンドウを描画"""
    imgui.begin("Geometry")

    # 表示モードの選択
    mode_names = ["Points", "Lines", "Triangles", "All"]
    changed, self._geometry_mode = imgui.combo("Display Mode", self._geometry_mode, mode_names)

    # === 点の設定 ===
    if imgui.collapsing_header("Points", imgui.TreeNodeFlags_.default_open.value):
        if self._point_geometry:
            # 点のサイズ
            changed_size, size = imgui.slider_float(
                "Point Size", self._point_geometry.point_size, 1.0, 20.0
            )
            if changed_size:
                self._point_geometry.set_point_size(size)

            imgui.text(f"Point Count: {self._point_geometry.vertex_count}")

            if imgui.button("Clear Points"):
                self._point_geometry.clear()

            if imgui.button("Add Random Point"):
                import random
                x = random.uniform(-1.0, 1.0)
                y = random.uniform(-1.0, 1.0)
                z = random.uniform(-0.5, 0.5)
                r, g, b = random.random(), random.random(), random.random()
                self._point_geometry.add_point(x, y, z, r, g, b)

    # ... 線・三角形も同様 ...

    imgui.end()
実行結果
起動すると、点・線・三角形が表示されます。imguiのGeometryパネルで:
- Display Mode: 表示する形状を切り替え
- Add Random: ランダムな位置に形状を追加
- Clear: 各形状をクリア
- Point Size: 点のサイズ調整(スライダー)

カメラ操作(ドラッグ・スクロール)も引き続き使用できます。
リソースの解放
OpenGLのリソース(VBO/VAO)は、使い終わったら明示的に解放する必要があります。
def cleanup(self) -> None:
    """リソースを解放する"""
    self._delete_buffers()

def _delete_buffers(self) -> None:
    """VBO/VAOを削除する"""
    if self._vbo:
        gl.glDeleteBuffers(1, [self._vbo])
        self._vbo = 0
    if self._vao:
        gl.glDeleteVertexArrays(1, [self._vao])
        self._vao = 0
    self._is_initialized = False
Appの終了処理で各ジオメトリのcleanup()を呼び出します:
def _shutdown(self) -> None:
    """終了処理"""
    # ジオメトリリソースの解放
    if self._point_geometry:
        self._point_geometry.cleanup()
    if self._line_geometry:
        self._line_geometry.cleanup()
    if self._triangle_geometry:
        self._triangle_geometry.cleanup()

    # シェーダーの解放
    if self._shader:
        self._shader.delete()
    # ...
ディレクトリ構成
今回追加・変更したファイル:
src/
├── main.py           # エントリポイント(変更なし)
├── core/
│   └── app.py        # ジオメトリ管理・imgui UI追加
├── graphics/
│   ├── __init__.py   # エクスポート追加
│   └── geometry.py   # 新規:ジオメトリクラス群
└── shaders/          # (変更なし)
まとめ
今回学んだこと:
- VBO(Vertex Buffer Object): 頂点データをGPUに格納
- VAO(Vertex Array Object): 頂点属性の設定を記録
- プリミティブタイプ: GL_POINTS, GL_LINES, GL_TRIANGLES
- 深度テスト: 3D描画での前後関係を正しく表示
- リソース管理: 使い終わったVBO/VAOは明示的に解放
ジオメトリクラスで抽象化したことで、点・線・三角形を簡単に追加・描画できるようになりました。
次回は、これを発展させて立方体や球体などの複合形状を描画します。インデックスバッファ(EBO)を使った効率的な頂点管理も学びます。
ソースコード
今回のコードは以下のGitHubリポジトリで公開しています。
次回予告
第9回「立方体と球体を描く」では:
- インデックスバッファ(EBO)の使用
- 四角形の描画
- 立方体と球体の頂点データ生成
- ワイヤーフレーム表示
お楽しみに!
前回: 第7回「マウスでカメラ操作」
【GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング】 - 第7回「マウスでカメラ操作」
GitHub Copilotと作る Pythonで OpenGL 3Dプログラミング
第7回「マウスでカメラ操作」
はじめに
前回は2D/3Dカメラクラスを実装し、それぞれの投影方式を学びました。今回はマウス操作でカメラを直感的に操作できるようにします。
3DビューアやCADソフトでは、マウスドラッグやホイールでカメラを自由に動かせることが必須です。今回はこの機能を実装します。
今回のゴール
- MouseController クラスでマウス入力を管理
- CameraController クラスでマウス操作をカメラに反映
- 3Dモード: 左ドラッグでオービット、右ドラッグでパン、中ドラッグで高さ調整、ホイールでズーム
- 2Dモード: 左ドラッグで回転、右ドラッグでパン、ホイールでズーム
- imgui との共存:UIウィジェット操作とカメラ操作を両立
マウス操作の設計
操作方式の選択
3Dソフトウェアによってマウス操作の割り当ては異なります。今回は以下の方式を採用しました:
| 操作 | 3Dモード | 2Dモード |
|---|---|---|
| 左ドラッグ | オービット(回転) | 回転 |
| 右ドラッグ | 水平パン(XZ/XY平面) | パン |
| 中ドラッグ | 高さ調整(Y/Z軸) | パン |
| ホイール | ズーム | ズーム |
座標系と水平面
3Dソフトウェアでは「上方向」の軸が異なる場合があります:
Y-up(OpenGL標準)       Z-up(CAD/工学系)
      Y                        Z
      |                        |
      |                        |
      +---- X                  +---- X
     /                        /
    Z                        Y

水平面: XZ平面            水平面: XY平面
高さ軸: Y軸               高さ軸: Z軸
- Y-up(OpenGL標準): Y軸が上方向。水平面はXZ平面(X軸とZ軸で構成)
- Z-up(CAD/工学系): Z軸が上方向。水平面はXY平面(X軸とY軸で構成)
今回の実装では両方の座標系に対応し、右ドラッグで水平面上を移動、中ドラッグで高さ軸方向に移動するようにしています。
クラス設計
マウス入力とカメラ操作を分離した設計にします:
MouseController
    ├── GLFWコールバック処理
    ├── ボタン状態管理
    ├── ドラッグ検出
    └── スクロール量取得

CameraController
    ├── MouseController参照
    ├── Camera2D参照
    ├── Camera3D参照
    └── マウス入力→カメラ操作変換
この分離により:
- マウス入力処理を再利用可能
- カメラ操作ロジックを独立してテスト可能
- 将来的にゲームパッド等の入力に対応しやすい
MouseControllerクラス
src/core/mouse_controller.pyを作成します。
"""
マウス入力管理モジュール
"""
from enum import IntEnum
from typing import Callable, Optional, Tuple

import glfw

from src.utils.logger import logger


class MouseButton(IntEnum):
    """マウスボタン"""
    LEFT = glfw.MOUSE_BUTTON_LEFT
    RIGHT = glfw.MOUSE_BUTTON_RIGHT
    MIDDLE = glfw.MOUSE_BUTTON_MIDDLE


class MouseController:
    """
    マウス入力を管理するクラス

    GLFWからのマウスイベントを処理し、
    ドラッグ状態やスクロール量を追跡する

    Note:
        既存のコールバック(imgui等)を保持し、チェーンで呼び出す
    """

    def __init__(self, window_handle) -> None:
        """
        マウスコントローラーを初期化する

        Args:
            window_handle: GLFWウィンドウハンドル
        """
        self._window = window_handle

        # マウス位置
        self._current_x = 0.0
        self._current_y = 0.0
        self._last_x = 0.0
        self._last_y = 0.0

        # ボタン状態
        self._button_pressed = {
            MouseButton.LEFT: False,
            MouseButton.RIGHT: False,
            MouseButton.MIDDLE: False,
        }

        # ドラッグ開始位置
        self._drag_start_x = 0.0
        self._drag_start_y = 0.0

        # スクロール量(フレームごとにリセット)
        self._scroll_x = 0.0
        self._scroll_y = 0.0

        # 既存のコールバックを保存(imgui等)
        self._prev_mouse_button_callback: Optional[Callable] = None
        self._prev_cursor_pos_callback: Optional[Callable] = None
        self._prev_scroll_callback: Optional[Callable] = None

        # 既存のコールバックを取得してから、新しいコールバックを登録
        # Note: glfw.set_*_callback は前のコールバックを返す
        self._prev_mouse_button_callback = glfw.set_mouse_button_callback(
            window_handle, self._mouse_button_callback
        )
        self._prev_cursor_pos_callback = glfw.set_cursor_pos_callback(
            window_handle, self._cursor_pos_callback
        )
        self._prev_scroll_callback = glfw.set_scroll_callback(
            window_handle, self._scroll_callback
        )

        # 初期位置を取得
        x, y = glfw.get_cursor_pos(window_handle)
        self._current_x = x
        self._current_y = y
        self._last_x = x
        self._last_y = y

        logger.info("MouseController initialized")
コールバックチェーンの重要性
imguiのGlfwRendererは初期化時にGLFWのマウスコールバックを登録します。MouseControllerがコールバックを上書きすると、imguiが反応しなくなってしまいます。
これを避けるため、既存のコールバックを保存してチェーンで呼び出す設計にしています:
def _mouse_button_callback(self, window, button: int, action: int, mods: int) -> None:
    """マウスボタンコールバック"""
    # 既存のコールバック(imgui)を先に呼び出す
    if self._prev_mouse_button_callback:
        self._prev_mouse_button_callback(window, button, action, mods)

    # 自分の処理
    if button in [MouseButton.LEFT, MouseButton.RIGHT, MouseButton.MIDDLE]:
        mouse_button = MouseButton(button)
        if action == glfw.PRESS:
            self._button_pressed[mouse_button] = True
            self._drag_start_x = self._current_x
            self._drag_start_y = self._current_y
        elif action == glfw.RELEASE:
            self._button_pressed[mouse_button] = False
この方式により:
- imguiのUI操作が正常に動作
- カメラ操作も同時に機能
- 複数のコールバックハンドラを共存可能
フレーム更新とプロパティ
def update(self) -> None:
    """
    フレーム更新

    前フレームの位置を保存し、スクロール量をリセット
    """
    self._last_x = self._current_x
    self._last_y = self._current_y
    self._scroll_x = 0.0
    self._scroll_y = 0.0

@property
def position(self) -> Tuple[float, float]:
    """現在のマウス位置"""
    return (self._current_x, self._current_y)

@property
def delta(self) -> Tuple[float, float]:
    """前フレームからの移動量"""
    return (self._current_x - self._last_x, self._current_y - self._last_y)

@property
def scroll(self) -> Tuple[float, float]:
    """スクロール量(X, Y)"""
    return (self._scroll_x, self._scroll_y)

@property
def is_left_dragging(self) -> bool:
    """左ボタンでドラッグ中か"""
    return self._button_pressed[MouseButton.LEFT]

@property
def is_right_dragging(self) -> bool:
    """右ボタンでドラッグ中か"""
    return self._button_pressed[MouseButton.RIGHT]

@property
def is_middle_dragging(self) -> bool:
    """中ボタンでドラッグ中か"""
    return self._button_pressed[MouseButton.MIDDLE]
delta: 前フレームからの移動量(ドラッグ速度)scroll: ホイールスクロール量(フレームごとにリセット)
CameraControllerクラス
src/core/camera_controller.pyを作成します。
"""
カメラコントローラーモジュール
"""
import numpy as np
from typing import Union

from src.core.mouse_controller import MouseController, MouseButton
from src.graphics.camera import Camera2D, Camera3D, UpAxis
from src.utils.logger import logger


class CameraController:
    """
    マウス入力でカメラを操作するクラス

    操作方法:
    - 左ドラッグ: オービット(3Dカメラのみ)/ 回転(2Dカメラ)
    - 右ドラッグ: パン(平行移動)
    - 中ドラッグ: パン(平行移動)
    - ホイール: ズーム
    """

    def __init__(
        self,
        mouse: MouseController,
        camera_2d: Camera2D,
        camera_3d: Camera3D,
    ) -> None:
        self._mouse = mouse
        self._camera_2d = camera_2d
        self._camera_3d = camera_3d

        # 操作の感度
        self._orbit_sensitivity = 0.5      # オービット感度(度/ピクセル)
        self._pan_sensitivity = 0.01       # パン感度
        self._zoom_sensitivity = 0.1       # ズーム感度
        self._rotation_sensitivity = 0.5   # 2D回転感度(度/ピクセル)

        # imgui上でのマウス操作を無視するフラグ
        self._enabled = True

        logger.info("CameraController initialized")
3Dカメラの更新
3Dカメラはオービット(球面座標での回転)、パン(水平面での移動)、高さ調整、ズームを実装します。
def _update_3d_camera(self, dx: float, dy: float, scroll: float) -> None:
    """3Dカメラを更新"""
    # 左ドラッグ: オービット(回転)
    if self._mouse.is_left_dragging:
        azimuth, elevation, distance = self._camera_3d.get_orbit()
        # 水平方向のドラッグで方位角を変更
        azimuth -= dx * self._orbit_sensitivity
        # 垂直方向のドラッグで仰角を変更(上下反転)
        elevation += dy * self._orbit_sensitivity
        # 仰角を-89〜89度にクランプ
        elevation = max(-89.0, min(89.0, elevation))
        self._camera_3d.set_orbit(azimuth, elevation, distance)
仰角を±89度にクランプしているのは、ジンバルロックを防ぐためです。真上や真下を向くと、方位角の回転軸が失われて操作が不安定になります。
水平パン(View行列からの方向取得)
右ドラッグで水平面上を移動します。ここでのポイントは、カメラの向きに応じた方向に移動することです。
# 右ドラッグ: パン(水平面での移動)
if self._mouse.is_right_dragging:
    # カメラのView行列から右方向と前方向を取得
    view = self._camera_3d.view_matrix
    # View行列の1行目が右方向
    right = np.array([view[0, 0], view[0, 1], view[0, 2]], dtype=np.float32)
    # View行列の3行目の符号反転が前方向
    forward = np.array([-view[2, 0], -view[2, 1], -view[2, 2]], dtype=np.float32)

    # 上方向の軸に応じて水平面に投影
    if self._camera_3d.up_axis == UpAxis.Z_UP:
        # Z-up: XY平面に投影(Z成分を0にして正規化)
        right[2] = 0.0
        forward[2] = 0.0
    else:
        # Y-up: XZ平面に投影(Y成分を0にして正規化)
        right[1] = 0.0
        forward[1] = 0.0

    # 正規化
    right_len = np.linalg.norm(right)
    if right_len > 0.001:
        right = right / right_len

    forward_len = np.linalg.norm(forward)
    if forward_len > 0.001:
        forward = forward / forward_len

    # スクリーン座標のドラッグをワールド座標の移動に変換
    move = -dx * self._pan_sensitivity * right - dy * self._pan_sensitivity * forward
    self._camera_3d.translate(move[0], move[1], move[2])
View行列から方向ベクトルを取り出す理由: - カメラの向きに連動: どの方向を向いていても「右にドラッグ→右に移動」 - 水平面に投影: 上方向成分を0にして、地面に平行な移動のみに制限
2Dカメラの更新
2Dカメラでは回転を考慮したパンが必要です。View行列から方向ベクトルを取得することで、回転後も正しい方向に移動できます。
def _update_2d_camera(self, dx: float, dy: float, scroll: float) -> None:
    """2Dカメラを更新"""
    # 左ドラッグ: 回転
    if self._mouse.is_left_dragging:
        rotation = self._camera_2d.rotation
        rotation -= dx * self._rotation_sensitivity
        self._camera_2d.set_rotation(rotation)

    # 右ドラッグまたは中ドラッグ: パン(平行移動)
    if self._mouse.is_right_dragging or self._mouse.is_middle_dragging:
        pos_x, pos_y = self._camera_2d.position
        zoom = self._camera_2d.zoom

        # View行列から右方向と上方向を取得
        view = self._camera_2d.view_matrix
        right_x = view[0, 0]
        right_y = view[0, 1]
        up_x = view[1, 0]
        up_y = view[1, 1]

        # スクリーン座標のドラッグをワールド座標系に変換
        scale = self._pan_sensitivity / zoom
        move_x = (-dx * right_x + dy * up_x) * scale
        move_y = (-dx * right_y + dy * up_y) * scale

        self._camera_2d.set_position(pos_x + move_x, pos_y + move_y)

    # ホイール: ズーム
    if scroll != 0.0:
        zoom = self._camera_2d.zoom
        zoom *= 1.0 + scroll * self._zoom_sensitivity
        zoom = max(0.1, min(10.0, zoom))
        self._camera_2d.set_zoom(zoom)
Appクラスへの統合
src/core/app.pyにMouseControllerとCameraControllerを統合します。
from src.core.mouse_controller import MouseController
from src.core.camera_controller import CameraController

class App:
    def __init__(self, width: int = 800, height: int = 600, title: str = "PythonOpenGL") -> None:
        # ... ウィンドウ、GUI、カメラの初期化 ...

        # マウスコントローラーとカメラコントローラーを初期化
        # Note: GUIの初期化後に行う(imguiのコールバックをチェーンするため)
        self._mouse = MouseController(self._window.handle)
        self._camera_controller = CameraController(
            self._mouse, self._camera_2d, self._camera_3d
        )
初期化順序が重要です:
1. Window → 2. GUI(imguiコールバック登録) → 3. MouseController(コールバックチェーン)
更新処理
def _update(self) -> None:
    """更新処理"""
    # imguiがマウスを使用中かチェック
    io = imgui.get_io()
    self._camera_controller.set_enabled(not io.want_capture_mouse)

    # カメラコントローラーを更新
    self._camera_controller.update(self._use_3d_camera)

    # マウス状態を更新(フレーム終了時)
    self._mouse.update()
io.want_capture_mouseをチェックすることで、imgui上でマウス操作している間はカメラ操作を無効化できます。
実行結果
実行すると、マウスでカメラを操作できるようになります。
3Dモード

- 左ドラッグで三角形の周りを回転(オービット)
- 右ドラッグで水平方向に移動(パン)
- 中ドラッグで上下に移動(高さ調整)
- ホイールでズームイン/アウト
2Dモード

- 左ドラッグでカメラを回転
- 右ドラッグで平行移動(回転後も正しい方向に移動)
- ホイールでズーム
まとめ
今回はマウスでカメラを操作する機能を実装しました。
学んだこと
- コールバックチェーン: 既存のコールバック(imgui)を保持して共存
- View行列からの方向取得: カメラの向きに連動した移動
- 座標変換: スクリーン座標→ワールド座標への変換
- 入力と操作の分離: MouseControllerとCameraControllerの責務分離
ファイル構成
src/
├── core/
│   ├── app.py               # Appクラス(統合)
│   ├── mouse_controller.py  # MouseController(マウス入力)
│   └── camera_controller.py # CameraController(カメラ操作)
├── graphics/
│   └── camera.py            # Camera2D/Camera3D
└── ...
クラス構成
MouseController
├── position: (x, y) - 現在位置
├── delta: (dx, dy) - 移動量
├── scroll: (sx, sy) - スクロール量
├── is_left_dragging, is_right_dragging, is_middle_dragging
└── update() - フレーム更新

CameraController
├── mouse: MouseController
├── camera_2d: Camera2D
├── camera_3d: Camera3D
├── orbit_sensitivity, pan_sensitivity, zoom_sensitivity
├── enabled: bool - imgui上では無効化
└── update(use_3d_camera) - カメラ更新
次回は基本形状描画を実装します。点・線・三角形の描画方法と、VBO(Vertex Buffer Object)・VAO(Vertex Array Object)の使い方を詳しく見ていきましょう。
前回: 第6回「2D/3Dカメラの実装」
次回: 第8回「点・線・三角形を描く」
